TiFlash 存算分离架构踩坑实录
1 一、背景
TiFlash 的好处和适应范围,这里就不多介绍了,大家都知道 TiFlash 可以极大的提高 AP 类查询的效率,所谓的 HTAP 数据库里 AP 主要就是通过 TiFlash 来实现的,不过 TiFlash 是列存模式,是作为 TiKV 的 Follower 角色来实现的,如果想达到高可用的状态,至少得提供 2 个副本,这样只从存储成本上来讲,相当于存储成本增长了 2/3, 这对很多公司而言,无疑会导致成本大幅度上升。
而 TiFlash 存算分离架构 通过把存储转移到 S3 上,可以大幅度降低存储成本的压力,经过一个多月的实战终于将存算分离架构上到了生产中,期间遇到了不少坑,这里给大家总结一下,减少大家可能遇到的问题。
PS: 当前 7.5.4/8.1.1 版本的存算分离在查询超大表时候,会出现报错,强烈建议大家使用 7.5.5 之后的版本上生产。详情见: https://asktug.com/t/topic/1035389
2 二、踩坑记录
具体如何切换以及基本原理,我这里就不过多介绍了,大家看 官方文档介绍,这里介绍几个踩过的坑,在基于阿里云 OSS 存储下的一些参数设计。
2.1 1. 不支持对 OSS 设置 Lifecycle
当前 TiFlash 对 OSS 的支持还不够完美,在默认配置参数下,TiFlash 设置 Lifecycle 会报错,导致 merge 或者 split 后的过期文件一直没办法被删除,OSS 上文件个数会一直增多,也会影响查询效率。需要设置参数:
3 2. Read 节点要调整 TCP 重传次数
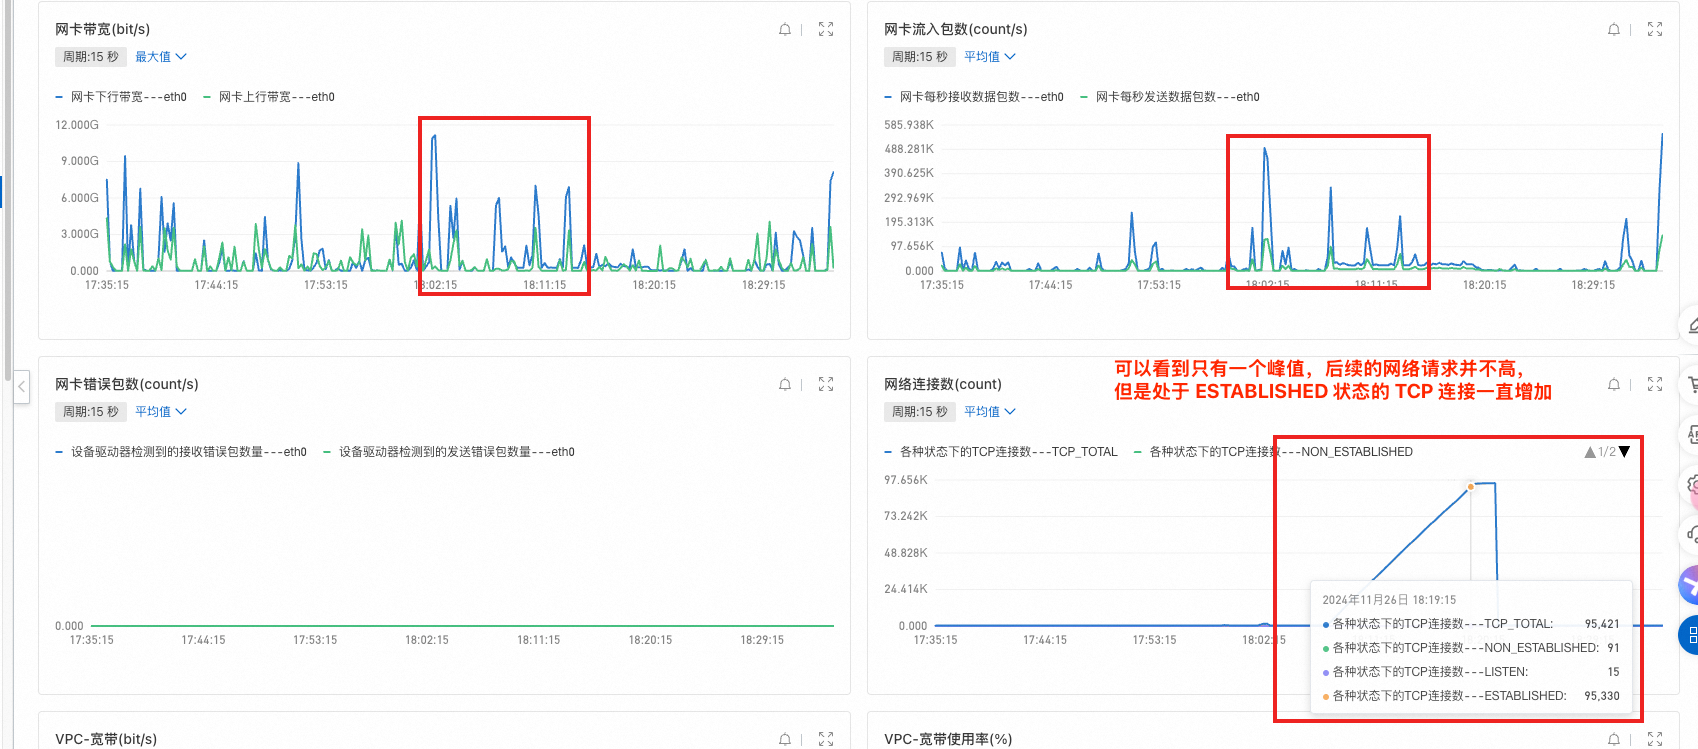
需要将操作系统的 net.ipv4.tcp_retries2从默认值 15 改为 5,tcp_retries2 是指 TCP 异常状态后最大重试的次数,只有重试超时后,才会将 TCP 连接关闭释放资源,从 15 改成 5,可以将重试时间从 910s 左右 降低到 20s 左右。
具体原因见之前帖子:
- https://asktug.com/t/topic/1035606
- https://asktug.com/t/topic/1035811
- https://asktug.com/t/topic/1035691
在出现问题时,往往是有查询特大表的 SQL 带来的短时间大量的 S3 网络请求(短时并发能超过 10W),这种瞬间并发请求可能达到 10 Gb/s,在默认操作系统配置下,刚开始每隔 1、2 天就会有 Read 节点的连接数增长到 100k,且不能自愈,期间业务所有走到 TiFlash 的查询都会被阻塞,会极大的影响业务,并造成雪崩。
4 3. Write 节点要设置 server.labels
具体原因可以见之前的帖子: TiFlash 存算分离两个 Write 节点的 Region 分布不均匀,这里只贴一下结论:
要设置 TiFlash 副本为 2,并且设置
LOCATION LABELS。 一个示例为:tiflash replica 2 LOCATION LABELS "host";Write 节点要设置
server.labels,这样设置LOCATION LABELS才会生效。
技术层面的原因是:
- 为什么会导致分布倾斜? PD 目前没有对象存储使用量的上报口。如果 tiflash 把对象存储的使用量当作 used size 上报,当对象存储的存储量接近本地盘容量的话,会导致 PD 停止调度 region 到那个 store 上。无法达到减少 write node 硬件成本的目的。 目前 write node 上报的 store 的使用量按照本地盘算,确实可能会导致调度不均衡。
- 最终会达到稳态么? TiFlash 的数据分为 Delta 层(新写入的小数据块)和 Stable 层。Delta 层的数据写入后累积达到阈值(一般 100w 行左右)会 Compact 为 Stable 层。Delta 层的数据也会上传 S3,但是本地数据需要等 Compact 为 Stable 层的时候才会清理。Stable 层的数据在上传 S3 之后会清理本地数据。本地的 delta 数据涨到一定程度后,维持在一个稳定的位置。 也就是如果数据一直都有大量写入,最终两者会是均衡的,但是如果两者写入速度有差异,一个先写完,另外一个写的比较慢,两者 Local 盘数据量有差异,就会导致这个差异一直存在,两者永远不会均衡。
4.1 4. Write 节点的 Local 数据量
先说结论:在极端情况下,Write 节点 Local 磁盘数据最大可能占总数据量的 8% ,所以要根据副本数以及总数据量来计算 Local 磁盘的大小。
原理介绍比较复杂,详细可以见官方的代码介绍:
我这里只摘出来关键内容:
单个 Segment 内部进一步按时域分为两层,一层是 Delta Layer(参见
DeltaValueSpace.h),一层是 Stable Layer(参见StableValueSpace.h)。可以简单地想象成是一个两层的 LSM Tree:Delta Layer 及 Stable Layer 在值域上是重叠的,它们都会包含整个 Segment 值域空间中的数据。新写入或更新的数据存储在 Delta Layer 中,定期 Compaction 形成 Stable Layer。其中单个 Segment 内的 Delta Layer 一般占 Segment 内数据的 5% 左右、剩余在 Stable Layer 中。
由于 Delta Layer 主要存储新写入的数据,与写入密切相关,而绝大多数需要读取的数据又在 Stable Layer 中,因此这种双层设计给予了我们分别进行优化的空间,这两层我们采用了不同的存储结构。Delta Layer 主要面向写入场景进行优化,而 Stable Layer 则主要面向读取场景进行优化。
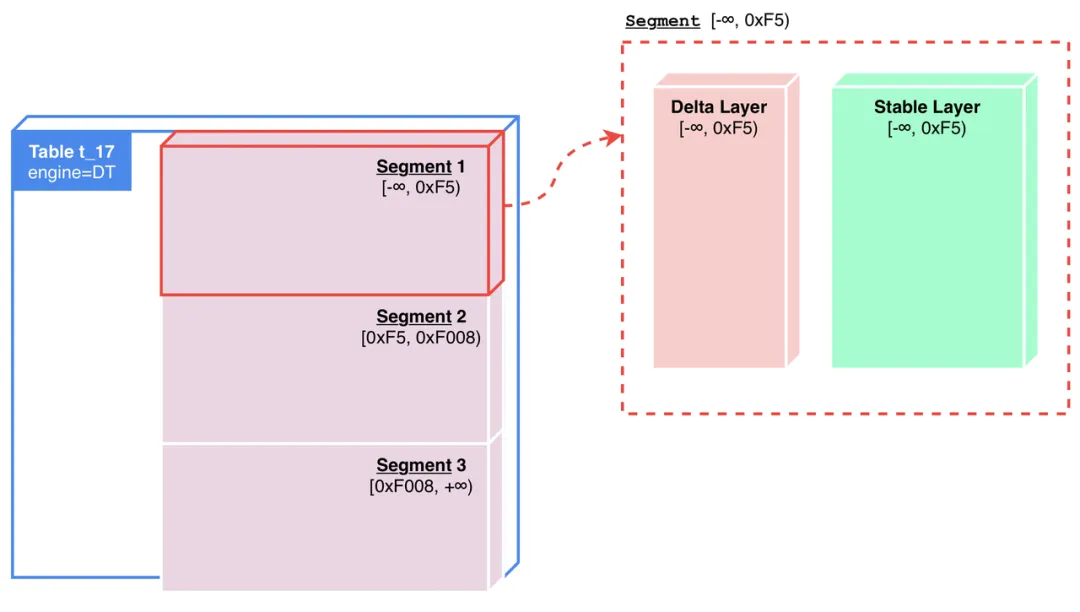
TiFlash 存算分离架构,其实就是把 Stable Layer 的数据放到了 S3 上,Delta Layer 的数据还是在 Write 节点 Local 磁盘保留,而这部分数据最大可占总数据量的 8%。
这个 8% 是怎么得到的呢? 其实是通过 TiFlash 对应参数 来计算的,默认情况下
dt_segment_delta_limit_size / dt_segment_limit_size = 42991616 / 536870912 = 0.08,也就是 8% 了。
文章中的 “定期 Compaction” 其实指的就是这个参数,而并不是真的是根据时间长短来 Compaction 的,如果 Segment 最后一次修改后 Delta Layer 的占比没有达到 dt_segment_limit_size 的阈值,这部分数据就一直不会被上传到 S3,而是保留在 Write 节点磁盘中。这种情况对按照递增主键的表(尤其是分区表) 而言可能很常见,所以我建议定时对分区表的历史分区数据在数据不发生变化后,主动做下 Compaction,具体可见官方介绍:https://docs.pingcap.com/zh/tidb/stable/sql-statement-alter-table-compact#alter-table–compact。
具体而言,就是定时检查 INFORMATION_SCHEMA.TIFLASH_TABLES 表中 TOTAL_DELTA_ROWS 列来观测 TiFlash 存储引擎上数据整理的进度,优先整理没有写入的历史分区。
5 5. Write 节点的机器配置
- CPU 可以不用太高,但是强烈建议 16C 以上,太低会影响 TiFlash 副本的同步效率。
- 内存则不能太低,根据实际数据量要求,会随着数据量的增大而变大,实测下来 810k Region 需要 100G 左右的内存。