TiDB 7.5资源管控能力测试
在7.1时候,其实已经对资源管控做了测试:TiDB 7.1 资源管控验证测试1。本文重点对7.1到7.5期间新增的资源管控能力进行测试,完整的功能特性见:TiDB 6.5升级7.5调研2
- 怎么理解
RU Quota?如何设置合理的RU Quota?一个复杂查询的RU成本竟然会有7W!
资源组的RU_PER_SEC限制的是资源组整体的消耗速度,可以看到RU的消耗其实是包含对TiKV读写请求封装的,虽然在TiKV层只有基于优先级的概念,没有直接对资源组做Quota限制,但是通过限制TiDB发送给TiKV 的请求数量,来间接达到TiKV基于Quota的限制。- 测试计划??
1 什么是 Request Unit (RU)
Request Unit (RU) 是 TiDB 对 CPU、IO 等系统资源的统一抽象的计量单位,用于表示对数据库的单个请求消耗的资源量。请求消耗的 RU 数量取决于多种因素,例如操作类型或正在检索或修改的数据量。目前,RU 包含以下资源的统计信息:
| 资源类型 | RU 消耗 |
|---|---|
| **Read** | 2 storage read batches 消耗 1 RU |
| 8 storage read requests 消耗 1 RU | |
| 64 KiB read request payload 消耗 1 RU | |
| **Write** | 1 storage write batch 消耗 1 RU |
| 1 storage write request 消耗 1 RU | |
| 1 KiB write request payload 消耗 1 RU | |
| **SQL CPU** | 3 ms 消耗 1 RU,也就是SQL执行时间为`1s`需要消耗的RU为`333` |
| SQL类型 | 示例 | RU消耗 |
|---|---|---|
| 普通表主键查询 | explain analyze select * from ying99_fundtxn.fund_market where id='94'; | 1.1 RU |
| 普通表唯一索引查询 | explain analyze select * from fund_market where FundCode='000117' and UpdateDate='20150924' ; | 3.4 RU |
| 普通表批量扫描1.3W行 | explain analyze select * from fund_market where importDay='20220901' ; | 312 RU |
| 分区表二级索引点查(包含分区键) | explain analyze select * from ying99_fundtxn.txn_confirm where AppSheetSerialNo='20190401009797711' and TransactionCfmDate='20190402'; | 1.6 RU |
| 分区表二级索引点查(不包含分区键、84个分区) | explain analyze select * from ying99_fundtxn.txn_confirm where AppSheetSerialNo='20190401009797711'; | 120 RU |
按照
CALIBRATE RESOURCE WORKLOAD TPCC预估,三个TiKV节点 + 1 8C64G TiDB节点的集群Quota为:38760
2 Resource Group日常操作
日常可以查看:
2.1 Quota对SQL执行的影响
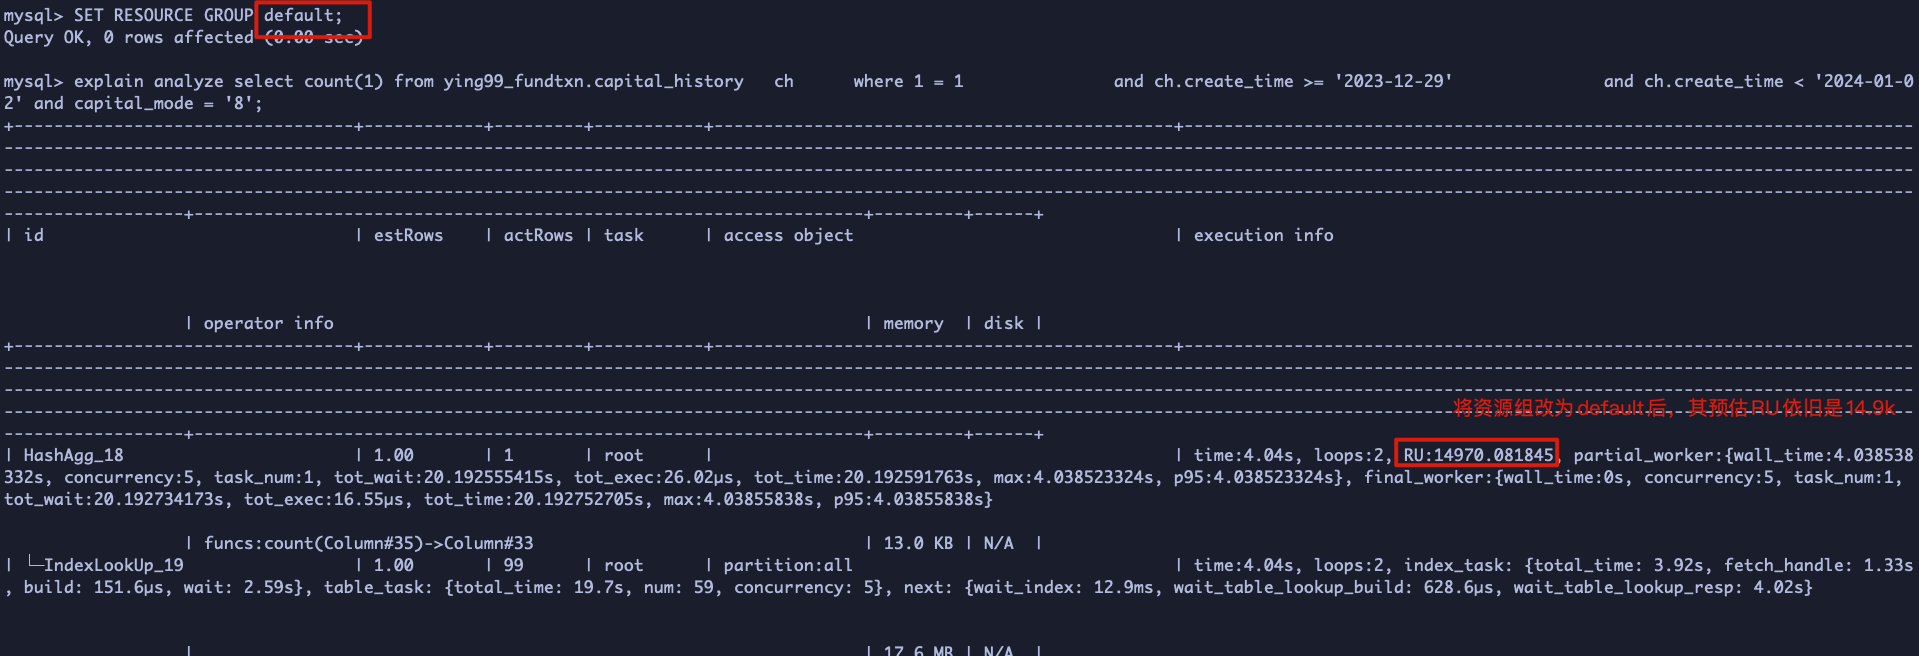
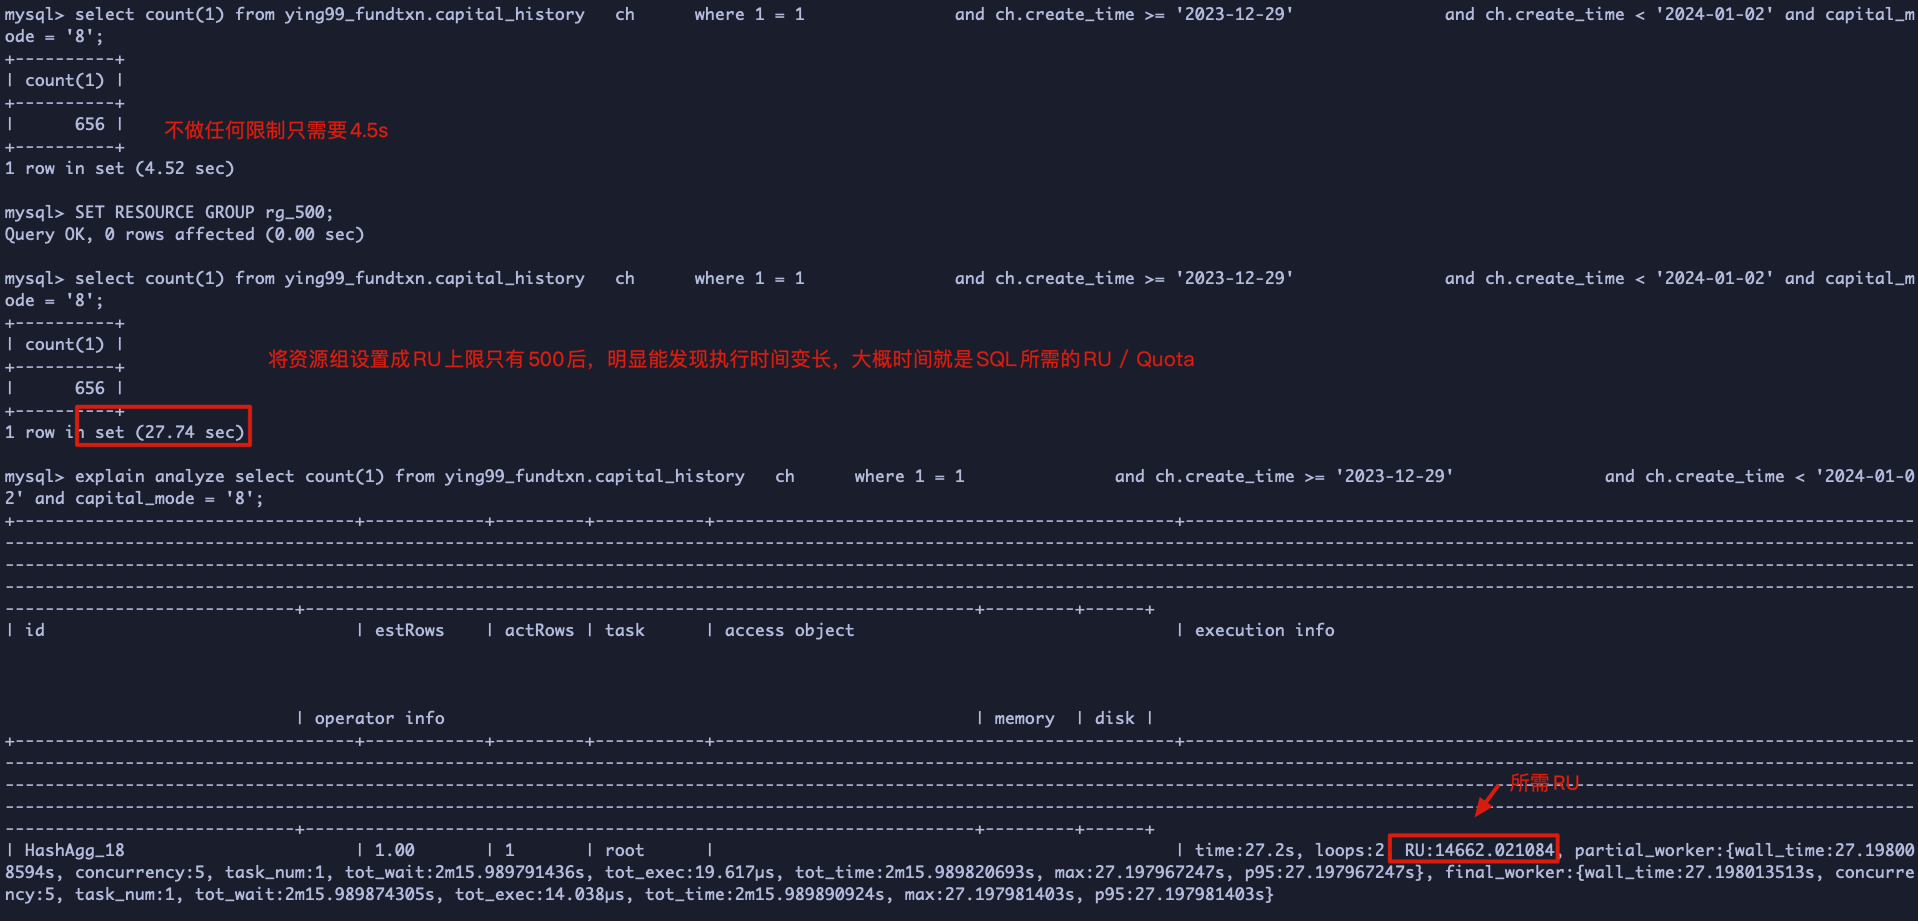
看截图可以发现,一个范围查询的SQL在没做任何限制时,执行时间是4.5s,所需RU是14k。当将session的资源组改成rg_500(RU_PER_SEC为500)后,执行时间变成了27.7s,实打实的可以做到削峰效果。
2.2 QUERY_LIMIT 参数设置
QUERY_LIMIT是自动识别,DBA不用干预,只要用户绑定了资源组,就会自动限制。
2.3 QUERY WATCH 语句说明
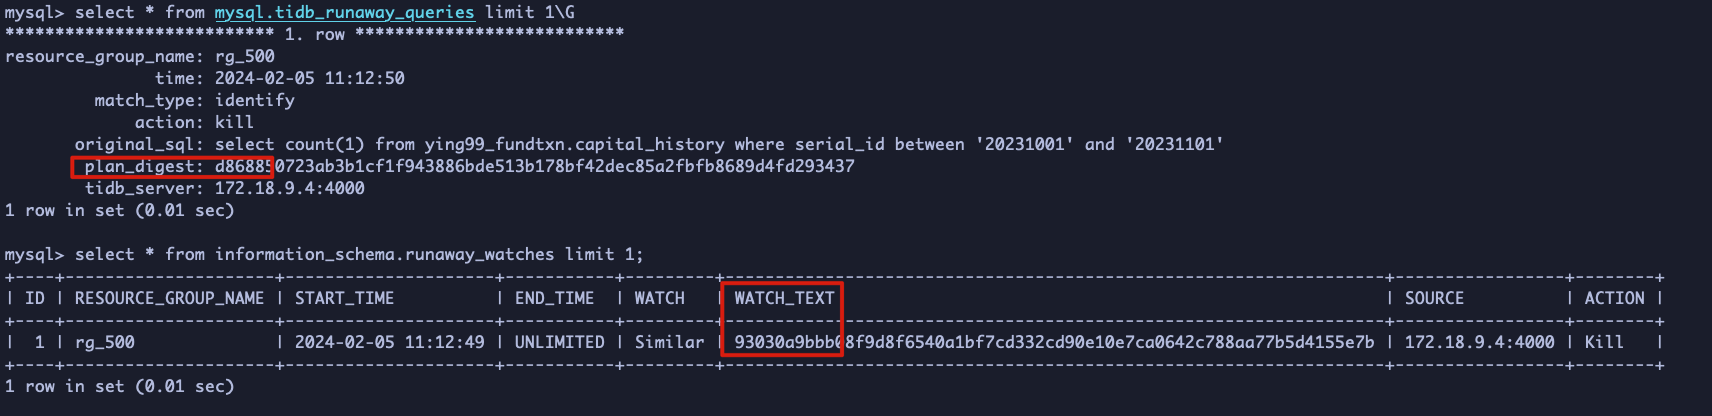
QUERY WATCH是被动识别,DBA需要主动对特定的SQL来进行限制。使用场景是,当某个OLTP用户突发出现了慢查询,可以手动将其加到QUERY WATCH里,防止影响集群性能。
2.4 管理超时语句
TiDB 7.1 资源管控验证测试
- https://tidb.net/blog/9cd7dcb3
- 本文章的重点在通过实验探索资源管控的一些细节表现,详细来讲就是:TiDB的流控能力和TiKV的调度能力。
- 2024-01-29 16:48:39
〇、背景
我们线上使用环境和李文杰大佬比较类似,我这里就不赘述了,大家可以看专栏 - TiDB v7.1.0 跨业务系统多租户解决方案 | TiDB 社区,这里比较清晰的介绍了7.1的资源管控原理和实践验证。
本文章的重点在通过实验探索资源管控的一些细节表现,详细来讲就是:TiDB的流控能力和TiKV的调度能力。
- TiDB流控能力:是看在tidb-server资源不足的情况,是否能正确按照Quota限制特定用户的使用资源。
- TiKV调度能力:是看在TiKV资源不足时候,能否优先响应高优先级的资源组请求,以及和当前tidb-server的优先级的区别。
一、测试环境准备
创建用户及资源组
准备测试数据
二、测评方案
2.1 TiDB流控测评
测试目标:
- 不同资源组连到同一个TiDB上,测试不同资源组之间的隔离性
- 同一个用户连到不同TiDB上,测试同一用户的Quota是否共用
- 同一资源组不同用户,测试同一资源组的Quota是否共用
2.1.1 不同资源组的隔离性
测试结果:
时序图
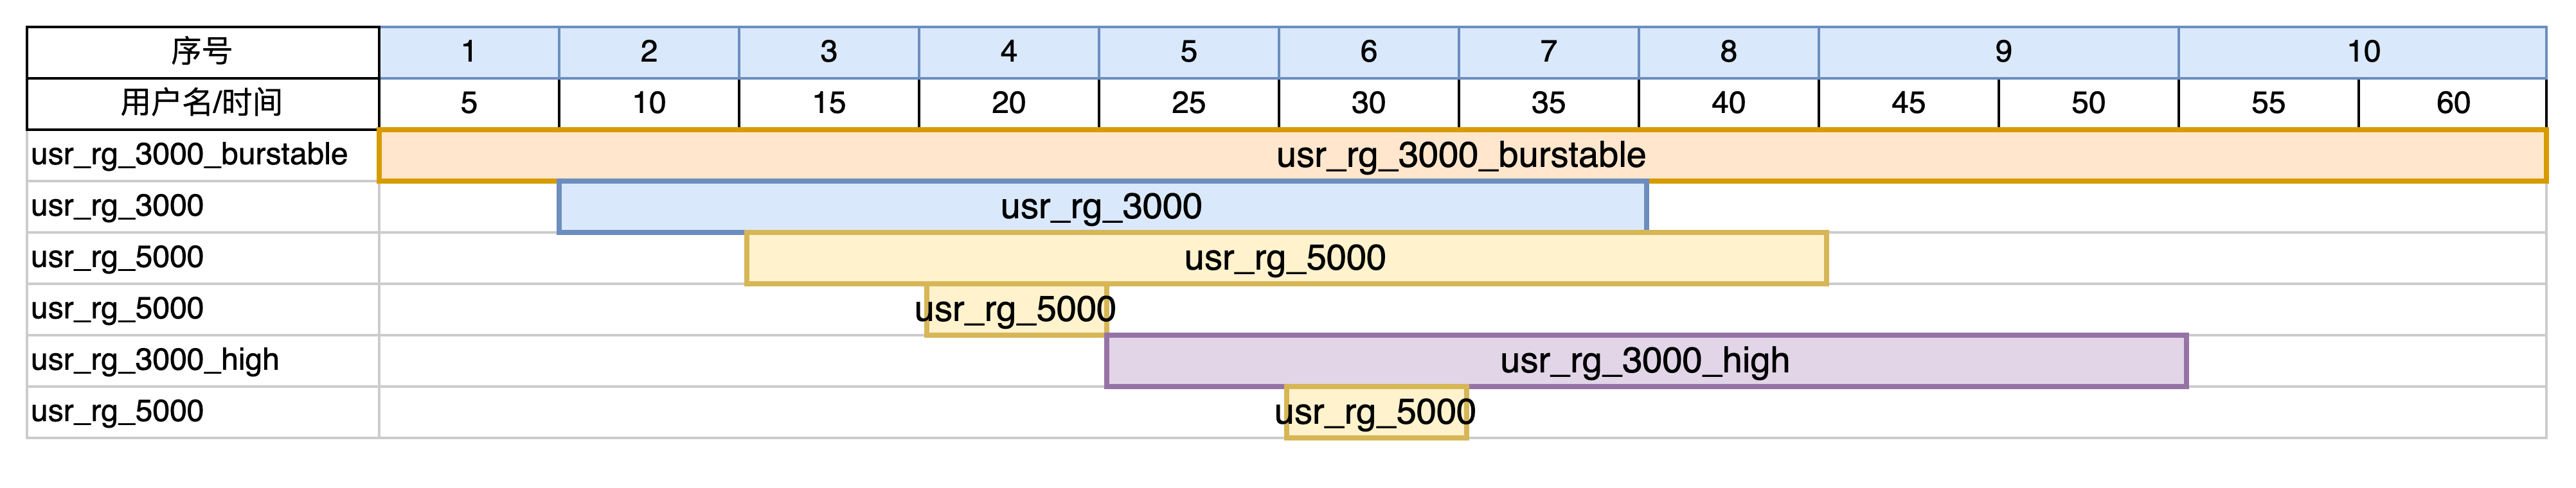
测试结果
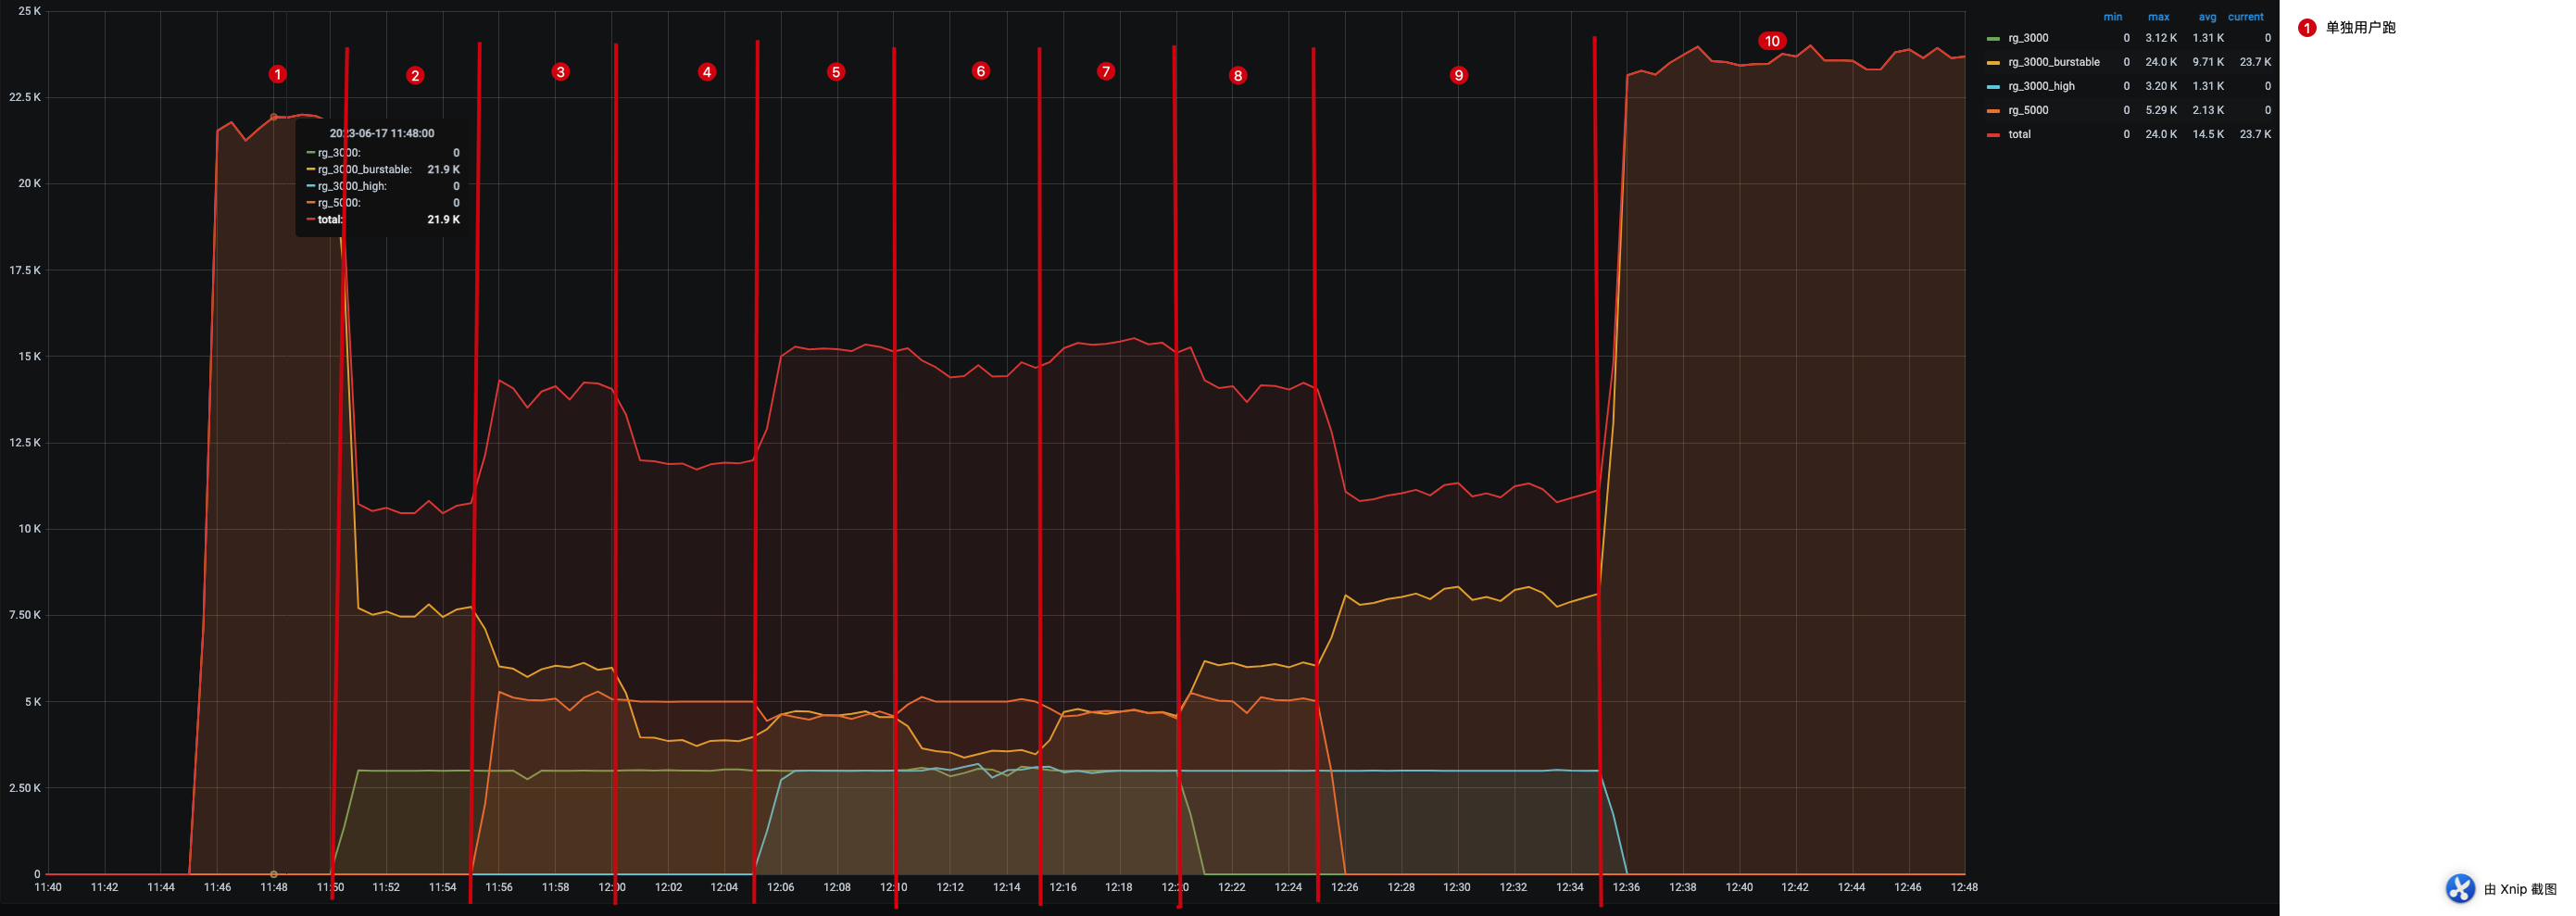
结果解析
- 阶段1: 由于只有
<span data-slate-string="true">usr_rg_3000_burstable</span>一个用户在使用集群,虽然Quota设置为3k,但因为设置了<span data-slate-string="true">BURSTABLE</span>可以跑到22k - 阶段2-4: 并发一直在增大,TiDB的负载在逐渐增加,
<span data-slate-string="true">usr_rg_3000_burstable</span>的流控曲线(黄色曲线)也越来越低,从22k、7.5k、6k逐步降低至4k - 阶段4: 虽然使用
<span data-slate-string="true">usr_rg_5000</span>用户新增了一个TPCC压测进程,但是总的资源消耗不变,还是5k。 - 阶段5: 随着
<span data-slate-string="true">usr_rg_5000</span>一个压测进程结束,<span data-slate-string="true">usr_rg_3000_burstable</span>的资源从4k增加到5k(不过<span data-slate-string="true">usr_rg_5000</span>总的资源消耗略有下降,从5k下降至4.8k,可能是TiDB压力太大导致的) - 阶段6: 继续使用
<span data-slate-string="true">usr_rg_5000</span> 用户新增了一个TPCC压测进程, 这一场景其实和阶段4比较类似,不过新增了<span data-slate-string="true">usr_rg_3000_high</span>资源组的压测进程,此时TiDB-Server的压力是最大的,几个资源组的曲线都略有波动,不过波动不大 - 阶段7-10: 随着其他资源组的压测进程逐渐结束,TiDB的负载在逐渐降低,
<span data-slate-string="true">usr_rg_3000_burstable</span>的流控曲线(黄色曲线)也越来越高,逐步回升到24k。
由此来看,TiDB-Server层的流控还是比较符合预期的,当负载压力小的时候,允许部分用户超额使用资源,当负载压力大的时候,又能保证其他用户的Quota正常。
2.1.2 同一用户不同 tidb-server
测试命令
测试结果
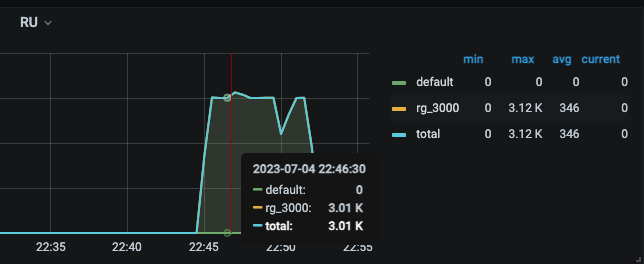
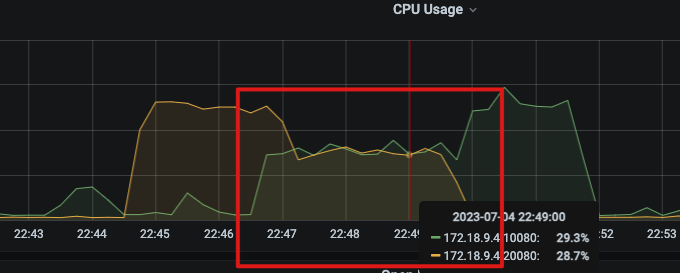
结果解析
- 观察RU使用曲线:在第二个压测进程启动后,资源使用会短时间高于Quota;当第一个压测进程结束后,资源使用会短时间低于Quota;不过很快就会回归正常Quota。
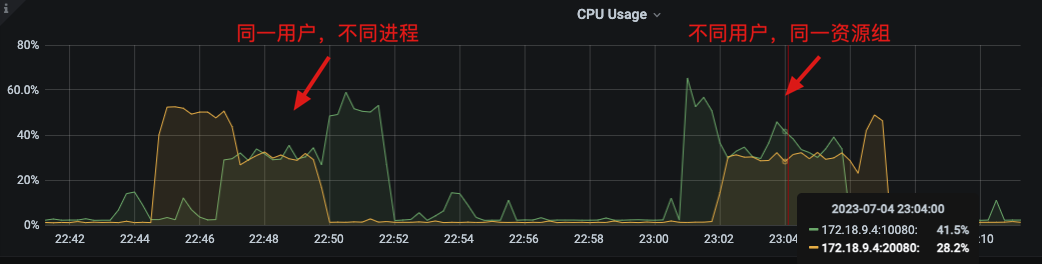
- 观察tidb-sever的CPU曲线:当只有一个压测进程在跑时候,单个tidb-server的CPU是正常使用的,当两个压测进程共同跑时候,两个tidb-server会平均分配负载,达到负载均衡的状态,更合理使用资源。
2.1.3 不同用户同一资源组
压测命令
压测结果
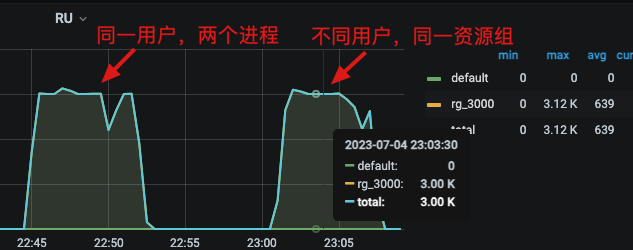
结果解析
通过监控曲线,可以看到同一资源组的两个不同用户,和同一用户两个不同压测进程的曲线是基本一致的,说明同一资源组内的不同用户是共享Quota的。
2.1.4 总结
因为同一资源组内不同用户是共享Quota的,所以个人理解的TiDB的流控最佳实践为:
- 对所有资源组都设置
BURSTABLE属性,这样才能提高TiDB-Server的资源利用率。 - 针对OLAP场景的用户,可以设置一个较小的Quota,当资源紧张时候,让它们尽可能小的占用资源,不影响OLTP的查询。
2.2 TiKV调度能力测试
由于2.1的测试案例,只有一个TiDB-Server实例,最终的TiKV压力并不大,看不出来TiKV层的优先级调度能力。使用
<span data-slate-string="true">tiup cluster edit-config</span>将tikv-server配置修改为<span data-slate-string="true">resource_control.cpu_quota: 400%</span>,降低TiKV的CPU资源。通过
<span data-slate-string="true">instance.tidb_force_priority</span>来对特定TiDB-Server上的查询来设置优先级,测试一下通过TiDB-Server隔离,和通过资源组来设置的优先级有什么区别。测试案例包括:
- 资源组PRIORITY不同,TiDB的PRIORITY相同
- 资源组PRIORITY相同,TiDB的PRIORITY不同
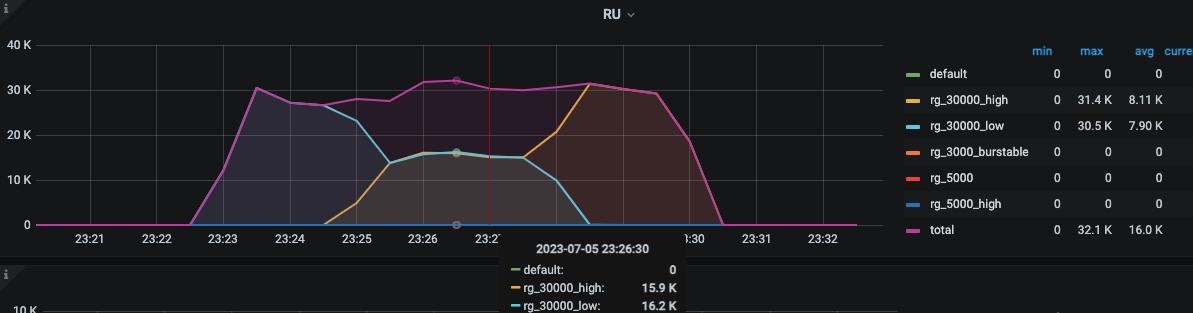
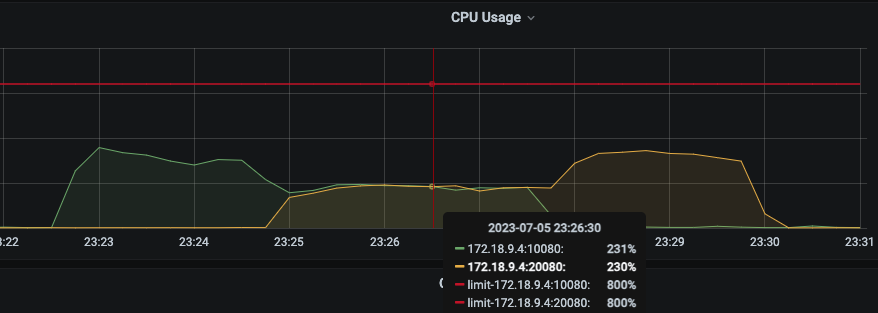
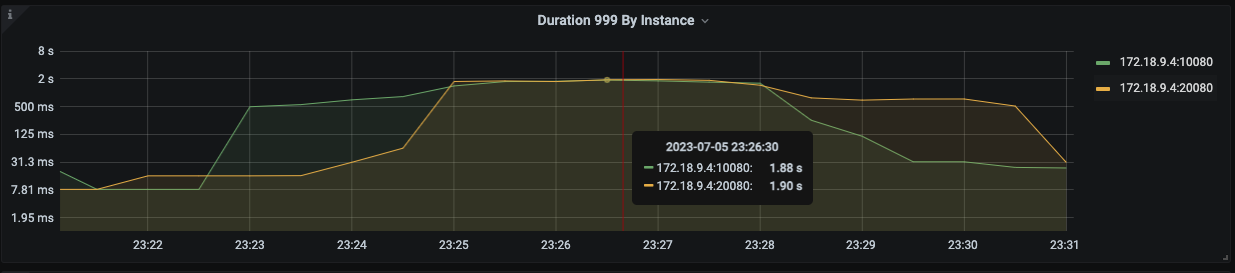
- 高PRIORIT的资源组连接低PRIORITY的TiDB vs. 低PRIORIT的资源组连接高PRIORITY的TiDB
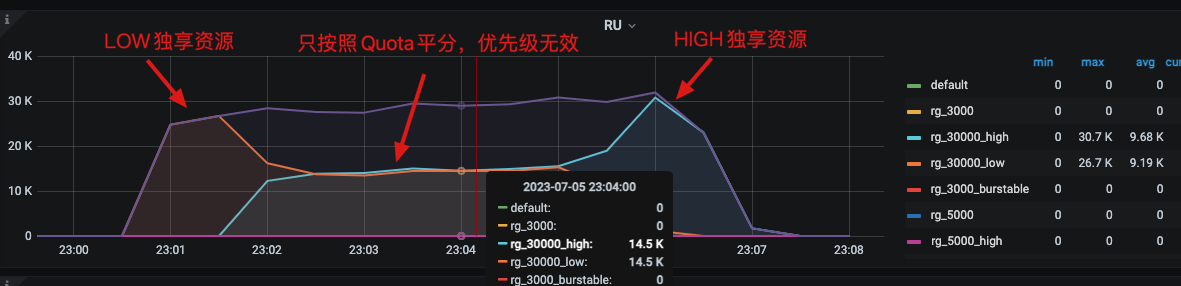
2.2.1 资源组PRIORITY不同,TiDB的PRIORITY相同
为使TiKV的CPU达到瓶颈,使用大Quota的资源组来进行测试
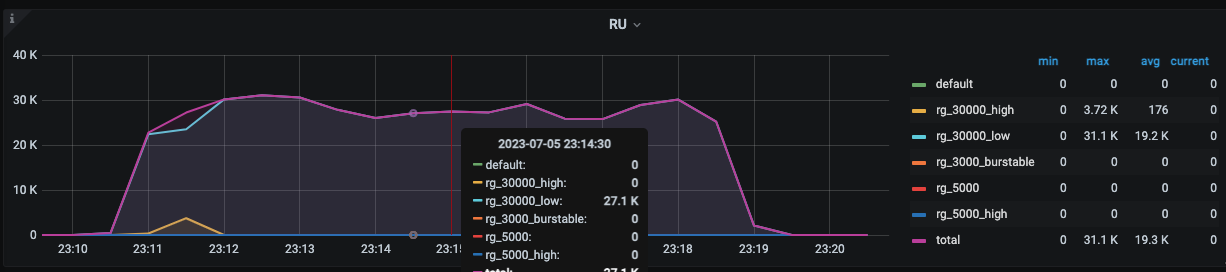
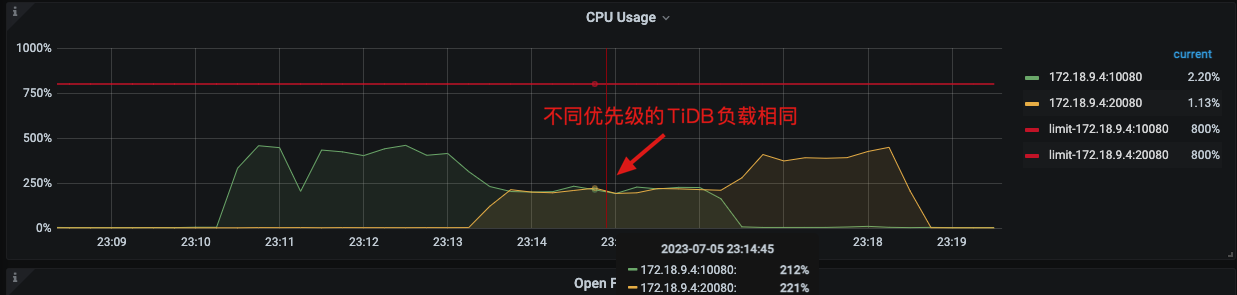
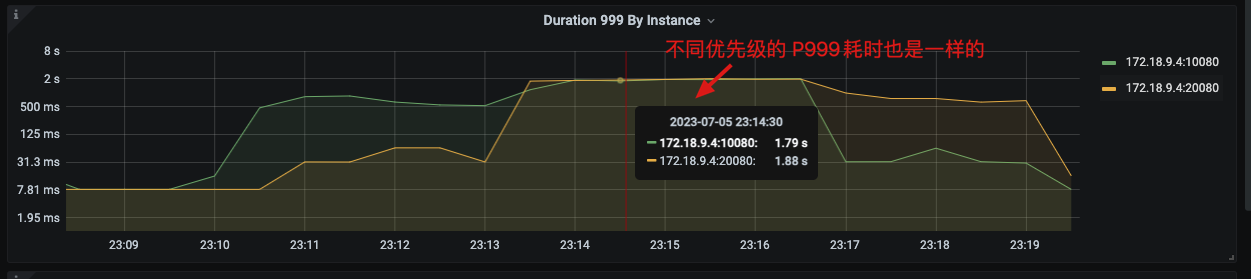
2.2.2 资源组PRIORITY相同,TiDB的PRIORITY不同
2.2.3 高PRIORIT的资源组连接低PRIORITY的TiDB vs. 低PRIORIT的资源组连接高PRIORITY的TiDB
2.2.4 总结
综合三次测试,可以发现不管是资源组优先级还是tidb-server的优先级,在TiKV层都是同样的处理,其调度能力并不能按照预期体现。
↩︎
TiDB 6.5升级7.5调研
新功能调研
Release Note:
- https://docs.pingcap.com/zh/tidb/stable/release-6.6.0
- https://docs.pingcap.com/zh/tidb/stable/release-7.0.0
- https://docs.pingcap.com/zh/tidb/dev/release-7.1.0
- https://docs.pingcap.com/zh/tidb/stable/release-7.5.0
杀手特性:
- TiFlash延时物化功能GA: 查询带Where的大表性能会提高很多。相关参数 tidb_opt_enable_late_materialization
- 资源管控GA: 资源管控在7.5的能力得到了极大的提升,支持按照用户、session、statement三个维度对SQL进行限制。还对自动识别并阻断慢查询,也支持对tiflash进行管控。 用户文档
- 优化统计信息缓存加载策略: 可以加快统计信息加载速度,并且可以设置统计信息加载之前不对外提供服务。相关参数lite-init-stats,force-init-stats
- 兼容性增强: 支持外键、支持 MySQL 兼容的多值索引 (Multi-Valued Indexes)、支持REORGANIZE PARTITION语法、对MySQL 8.0的兼容性更强了。
- TiFlash支持**存储计算分离和 S3 共享存储 : 可以将TiFlash数据存储到S3中,这样所有的表都可以有TiFlash副本,可以让OLAP的流量只访问TiFlash,和OLTP彻底隔离。**
- 后台任务管控能力增强: 可以指定tidb-server机器来执行ddl和import任务,防止后台任务影响OLTP查询。DDL支持暂停和恢复功能。
- DM增加**增量数据校验功能** : 可以实时检查DM同步任务是否正常
其他优化:
支持自适应副本读取缓解读热点: 减少热点查询的长尾延时,提高吞吐量。相关参数 tidb_load_based_replica_read_threshold
**store-limit-version** : 可以根据TiKV负载动态调整region迁移速度,不需要手动调整,可以加快日常将数据迁移到HDD节点的速度。不过还是实验特性,不建议开启
TiCDC性能优化: 修复在上游执行rename table时可能导致changefeed报错的BUG,支持输出变更到S3存储中
DDL 支持分布式并行执行框架: 可以多节点执行同一DDL,增加DDL执行速度。
Partitioned Raft KV: 每个region由单独的rocksdb来管理,可以极大的加快扩缩容速度,以及热点读写隔离。不过不支持动态修改,只能在创建TiDB集群时指定,不建议开启。
TiKV 支持自动生成空的日志文件用于日志回收: raft-engine.prefill-for-recycle
Fast Online DDL兼容性更好,支持更多场景,兼容PITR。
BR 支持备份和恢复统计信息
TiDB Dashboard 性能分析支持 TiKV 堆内存分析
IMPORT INTO SQL 语句成为正式功能 (GA): 该语句集成了 TiDB Lightning 物理导入模式的能力,可以将 CSV、SQL 和 PARQUET 等格式的数据快速导入到 TiDB 的一张空表中,只能适应于新表的导入。https://docs.pingcap.com/zh/tidb/dev/sql-statement-import-into优化 ANALYZE 流程: 引入 tidb_build_sampling_stats_concurrency 精细化控制 ANALYZE 并发度,减少资源消耗。同时优化 ANALYZE 的内存使用,通过复用部分中间结果,减少内存分配,避免频繁 GC
对分区表的常用操作基本完全兼容
- 支持普通表 <==> 分区表之间相互转换
- 支持
REORGANIZE PARTITION语法
启用哪些功能?
**资源管控:用户文档** , 大部分用户不做资源管控,只控制一些特定job用户、以及dms-user的Quota
**开启TiFlash存储计算分离和 S3 共享存储:**https://docs.pingcap.com/zh/tidb/stable/tiflash-disaggregated-and-s3
tidb-server:
- lite-init-stats
- force-init-stats
- **temp-dir** : 默认是
/tmp/tidb目录在系统盘,读写性能和磁盘大小都有限,调整到data-dir中 - **tidb_enable_ddl** : 将OLTP节点的值设置为false,禁止在OLTP节点上执行DDL语句
- **
tidb\_enable\_dist\_task** : 可以多节点执行同一DDL,增加DDL执行速度。 -
tidb_service_scope: 限制tidb-server是否执行后台任务(只能在升级后,在olap tidb-server上设置) - tidb_enable_async_merge_global_stats:用于设置 TiDB 使用异步方式合并统计信息,以避免 OOM 问题,对分区表生效。解决新增分区后,新分区不会自动analyze的BUG
tikv-server
tiflash-server: 开启存算分离架构,操作文档: https://docs.pingcap.com/zh/tidb/stable/tiflash-disaggregated-and-s3
开启TiFlash存算分离架构,需要将现有TiFlash节点释放掉,所以需要找一个低峰期,所有表的tiflash副本都设置为0。(不会导致查询失败,但是某些SQL的查询耗时可能会变大)Grafana Dashboard更新Prometheus Alert规则更新对比
调研文档
- TiDB 7.5资源管控能力测试
- TiFlash存算分离架构测试3
性能提升
测试案例 6.5 7.5 ANALYZE TABLE3 min 18.68 sec1 min 26.69 secbr restore635 MB/stidb-lightningset tiflash replica- local tiflash:
- tiflash on s3:read on tiflash- local tiflash:
- tiflash on s3: ↩︎
TiFlash存算分离架构测试
已确认问题:
- 官方不建议设置太多的TiFlash副本,担心PD中
Placement Rule太多,影响PD性能。已经验证修改default策略不可行:TiFlash修改默认Placement Rule方案测试4 - 默认情况下对OSS的兼容性还有待调查: OSS兼容性测试5
- 当前TiFlash挂掉后,只会从TiKV获取数据,不能从S3获取存量数据。也就是说,一旦TiFlash节点挂掉没办法起来,在重做时候,新节点会全量把所有数据都拉一遍,历史信息也会被重新上传到S3上,存在长时间TiFlash不可用的情况,所以官方建议至少设置两个
Write Node,两个副本。
PS:如果设置两个副本,在S3上也会存两份,会存在空间浪费。
PPS:针对盈米而言,这个问题不大,我们的Write Node到时候会用云盘,数据不会丢。只要IP不变,就不会重做,也就不需要重传数据
但是这种情况下,任何访问 TiFlash 的 SQL 都会报错,会影响可用性。同时在升级集群版本时候,也没办法做到平滑升级。
当前现状
如下排查所示,当前总共有
12k的表/分区,排除掉kyc_feature_store_offline这个库之后,有7705个表/分区。而当前的Placement Rule个数有6189个(包含kyc_feature_store_offline),如果减去kyc_feature_store_offline的表后,只有1752个。需要确认,在on_dw_ssd下的分区表,会产生多个
Placement Rule还是只有一个。测试案例
购买两个机器,一个作为write_node,一个作为
compute_node,在扩容后,Q:通过修改
default策略,是否可以让所有表都有tiflash副本?
A: 不可行,索引上的Region不能设置TiFlash副本,会导致TiFlash报错。详细测试见: TiFlash修改默认Placement Rule方案测试4Q:
write_node节点的磁盘是否能有限制?
A: 通过监控可以发现local盘数据量,即便是在迁移期间也一直只有4 MB。在OSS上的内容在初始上传后有96 GB,不过在经过一段时间稳定后只有55 GB。通过这里,也就可以发现TiFlash on S3架构现阶段时将S3当成普通的磁盘来使用的,是有多少个write_node节点,在S3上就有多少个子目录,每个目录对应一个write_node节点。日常的Merge/Split/Add/Delete操作,都需要直接读写S3中的数据。
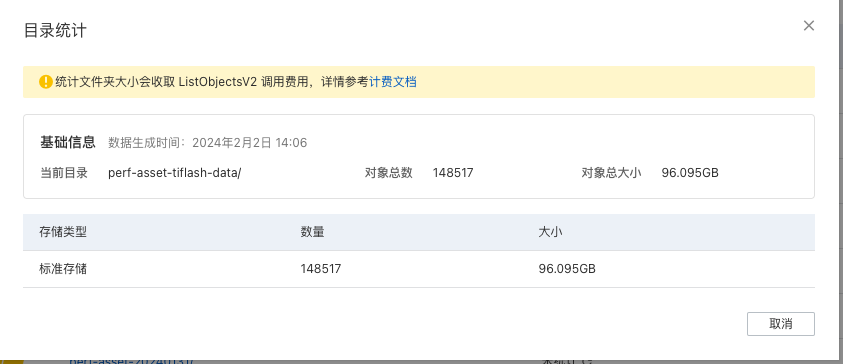
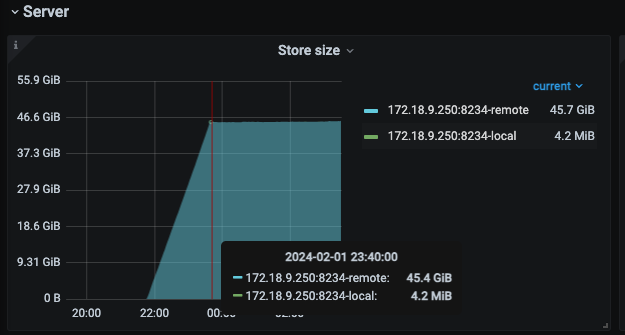
在
set tiflash replica 0取消Tiflash副本后,OSS上数据会不会被清理掉?
当执行set tiflash replica 0后,tiflash_replica系统表及config placement-rules show都立刻看不到之前设置的表,但是tiflash副本是异步删除的,即便tiflash write_node节点状态为Tombstone后,数据依旧不会马上被清理。正常来说在执行tiup cluster prune时候应该会把tiflash的数据给删掉,但是当前只会删除本地的数据目录,而OSS上数据会一直存在,不会自动删除。在
增加TiFlash副本时,对OSS操作的冲击力?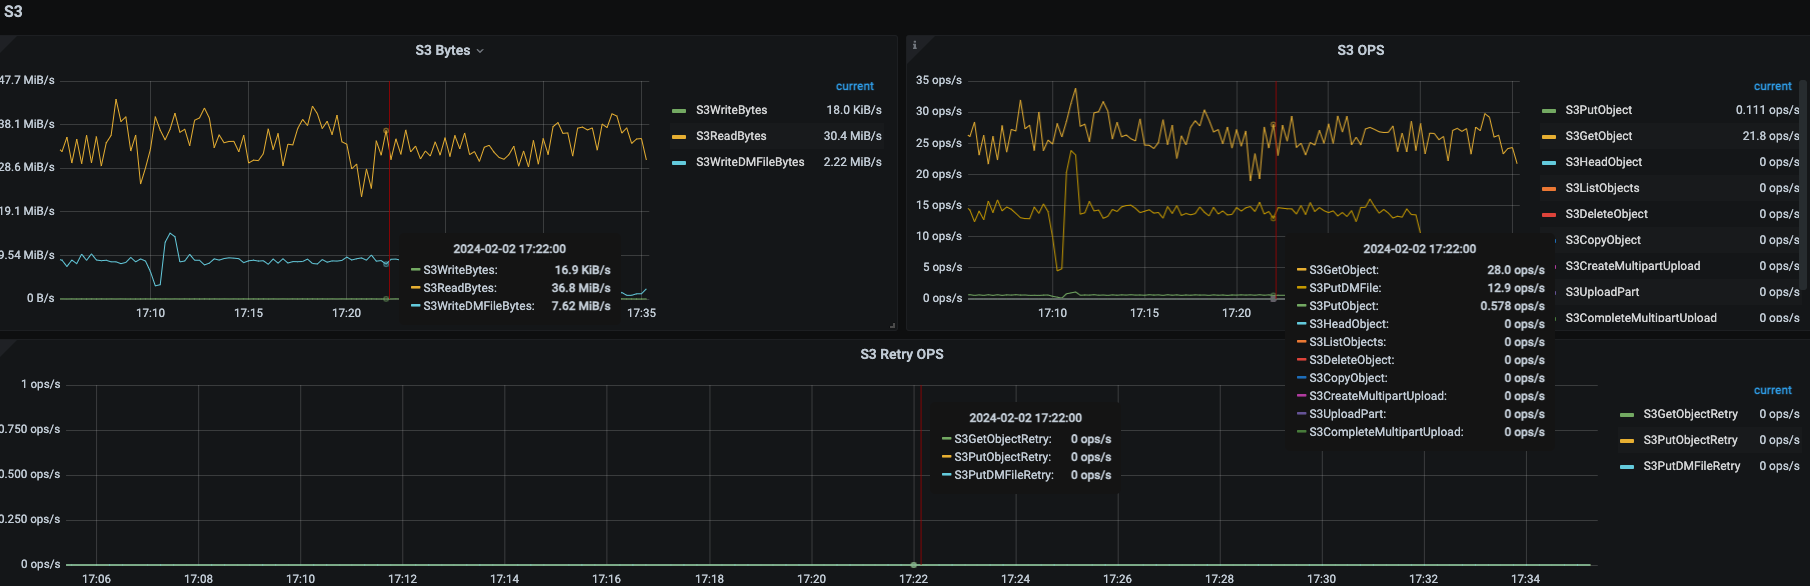
如上图所示,对OSS操作都很低,影响很小,OPS只有几十。
类型 OPS 带宽 上传 30 8 MB/s下载 13 38 MB/s在用
br restore时候,恢复速度会大幅上升,10:52 ~ 11:23数据量从45.2 GB上升到83.7 GB,速度是20.7 MB/s,OSS上数据从56.191GB上升到102.619GB, 速度是24.9 MB/s差别不大。TiKV数据量是156 GB,平均速度是83.9 MB/s。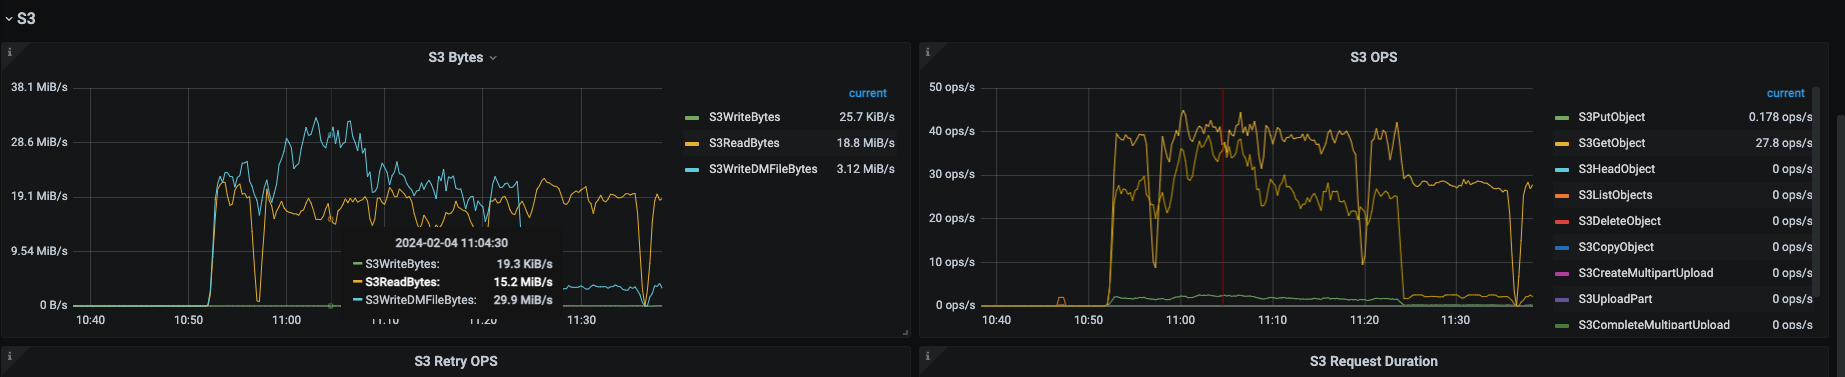
在OSS上的平均文件大小是
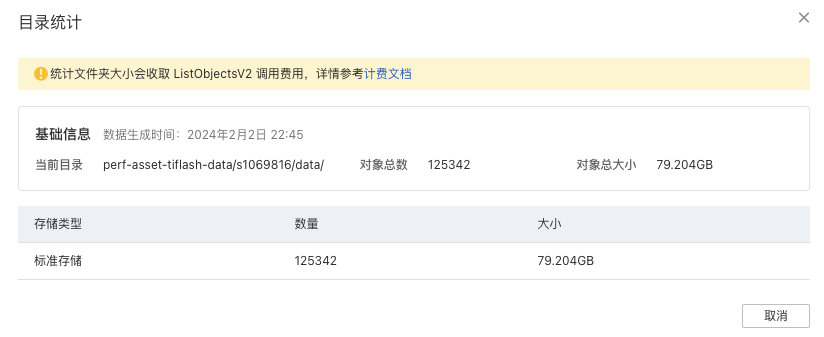
79.2 GB * 1024 / 125342 = 0.64 MB = 640 KB。(本地盘情况,平均文件大小是1.6 MB)
在计算时,
write_node/compute_node的资源使用比例是多大?
Write Node 节点在计算时的资源使用量很少,但是为了维护 TiFlash region 状态,自身的 CPU 和 内存都不能太低,尤其是内存,和数据量基本是成正比关系。TiFlash迁移速度:
TiDB上ying99_fundtxn.fund_order在TiKV上数据量是220G,经过15:38 ~ 17:28共上传77G TiFlash数据,平均是7.6 MB/s,最终是56 GB,折合TiKV上数据,速率是34 MB/s,也就是2 GB/min, 120 GB/h。在
compute_node节点故障后,只write_node节点不能对外提供服务,会报错:ERROR 1105 (HY000): tiflash_compute node is unavailable
PS: write Node 故障后,一样会导致查询报错。兼容性测试:
在br restore恢复库表时候,TiFlash节点会自动将数据增加副本
TiFlash存算分离架构的性能如何?
写速率:21:47开始同步,23:39结束同步,总共迁移45 GB数据,原始表为220G
测试案例 调研结果 结论 通过修改default策略,是否可以让所有表都有tiflash副本? 不可行,原因是索引上的Region不能设置TiFlash副本,一旦设置所有region都添加tiflash副本,会导致TiFlash报错没办法启动。 必须逐个表/database来添加tiflash副本,新增表默认是没有tiflash副本的 存算分离架构对OSS兼容性测试 当前TiFlash对OSS的支持还不够完美,在默认配置参数下,会有报错导致没办法在merge或者split后删除历史数据,导致一直在重试。需要设置参数: # 默认值是1,通过S3的Lifecycle方式自动清理过期数据。设置为2,可以调整为原始的Scan模式,通过ListObject方式来找到过期数据并删除。profiles.default.remote_gc_method: 2扩容时候,write_node配置中增加profiles.default.remote_gc_method: 2 write_node节点的磁盘配置? - 通过监控可以发现local盘数据量,即便是在迁移期间也一直只有4 MB。在OSS上的内容在初始上传后有96 GB,不过在经过一段时间稳定后只有55 GB。
- 通过这里,也就可以发现TiFlash on S3架构现阶段时将S3当成普通的磁盘来使用的,是有多少个write_node节点,在S3上就有多少个子目录,每个目录对应一个write_node节点。日常的Merge/Split/Add/Delete操作,都需要直接读写S3中的数据。write_node节点的配置可以很低,预计4C16G + 20G SSD就够了 缩容tiflash后,OSS上数据会不会被清理掉? 当执行set tiflash replica 0后,tiflash_replica系统表及config placement-rules show都立刻看不到之前设置的表,但是由于tiflash副本是异步删除的,即便tiflash write_node节点状态为Tombstone后,数据依旧不会马上被清理,还在OSS中。
正常来说在执行tiup cluster prune时候应该会把tiflash的数据给删掉,但是当前只会删除本地的数据目录,而OSS上的数据只能等待异步清理完成后,才会释放(可能持续很长时间)。只缩容一个tiflash write_node时,不需要手动清理OSS上数据。只有所有tiflash节点都需要缩容时(比如要切换回旧模式时),才需要手动清理OSS上文件夹。 在增加TiFlash副本时,对OSS操作的冲击力? 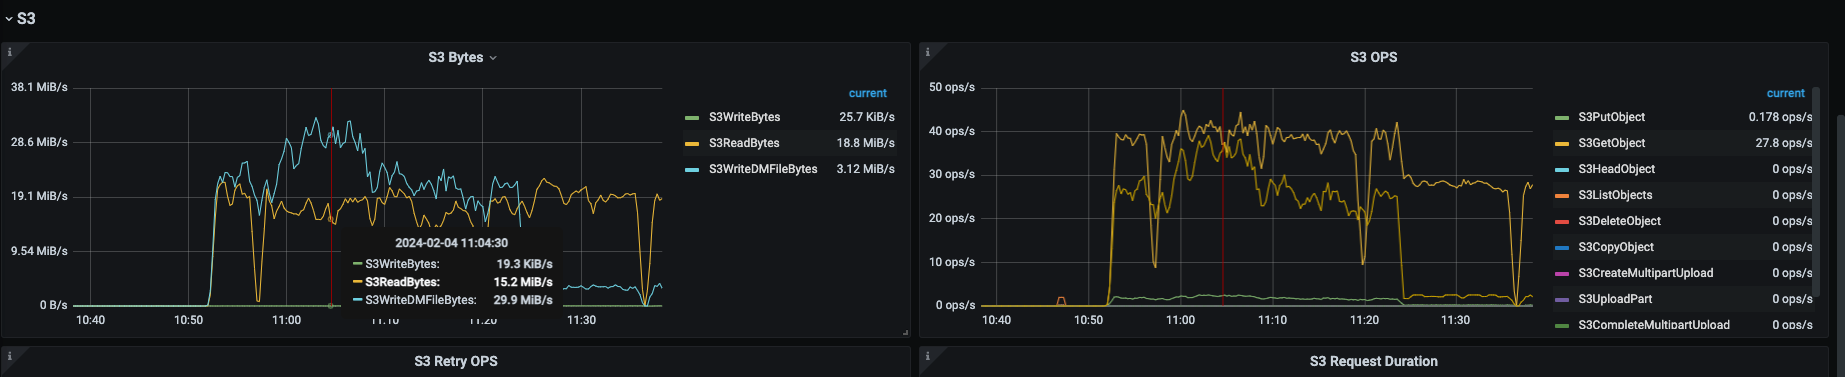
如上图所示,对OSS操作都很低,影响很小,OPS只有几十,上传/下载带宽也很小。对OSS冲击力很小,不需要额外关注 TiFlash迁移速度 local tiflash:
16:20开始导入,18:03导入完成,总共是103min,导入后TiFlash总数据量是39G,导入速率是6.3 MB/s,按照TiKV数据量来算是25 MB/s, 87.9 GB/h。
- 最终产生的平均文件大小是1.5 MB。
tiflash on s3:
- 09:44开始导入,11:28导入完成,导入后TiFlash总数据量是39G,导入速度是6.8 MB/s。TiKV数据量时156 GB,折合导入速度是25 MB/s, 87.9 GB/h
- 开始:对象总数:72488,对象总大小:73.611GB,平均对象大小为1.4 MB。
- 稳定后:对象总数:84692,对象总大小:85.748GB在同步速度方面,两者速度差不多,单表同步速度大概是 90 GB/h。需要计算一下大量表一起添加tiflash副本需要的时间 在计算时,write_node/compute_node的资源使用比例是多大? 待测试 故障测试 在compute_node节点故障后,只write_node节点不能对外提供服务,会报错:ERROR 1105 (HY000): tiflash_compute node is unavailable 7.5新版本的TiFlash查询效率 走where条件的范围查询:* TiDB 6.5 (两个tiflash节点): 0.9s* TiDB 7.5 (单个local tiflash节点): 0.36s,性能提升60%。* TiDB 7.5 (存算分离架构,单个compute节点): 待测试
上线方案
- 迁移到sata盘的表,必须增加tiflash副本
- 当前的已有tiflash副本的表,需要提前找到,在切换到
- 官方不建议设置太多的TiFlash副本,担心PD中
TiFlash修改默认Placement Rule方案测试
导出当前集群的
placement-rules在
PD默认规则里加上一下的告警规则将新的规则导入到
PD中观察集群:发现这个时候,
TiFlash节点会报错,发生重启。查看日志能发现提示start_key和end_key不对。根据查了下报错的那个
start_key所在的region是属于一个索引的,而正常通过set tiflash replica方式增加的Placement rule,其start_key和end_key都是主表的。
OSS兼容性测试
当前TiFlash对OSS的支持还不够完美,在默认配置参数下,会有报错导致没办法在merge或者split后删除历史数据,导致一直在重试。需要设置:
↩︎