# TiDB 7.1 资源管控验证测试
LLMS 索引: [llms.txt](/llms.txt)
---
---
- [https://tidb.net/blog/9cd7dcb3](https://tidb.net/blog/9cd7dcb3)
- 本文章的重点在通过实验探索资源管控的一些细节表现,详细来讲就是:TiDB的流控能力和TiKV的调度能力。
- 2024-01-29 16:48:39
---
# 1 〇、背景
我们线上使用环境和李文杰大佬比较类似,我这里就不赘述了,大家可以看[专栏 - TiDB v7.1.0 跨业务系统多租户解决方案 | TiDB 社区](https://tidb.net/blog/2ce19df3),这里比较清晰的介绍了7.1的资源管控原理和实践验证。
本文章的重点在通过实验探索资源管控的一些细节表现,详细来讲就是:TiDB的流控能力和TiKV的调度能力。
- **TiDB流控能力**:是看在tidb-server资源不足的情况,是否能正确按照Quota限制特定用户的使用资源。
- **TiKV调度能力**:是看在TiKV资源不足时候,能否优先响应高优先级的资源组请求,以及和当前tidb-server的优先级的区别。
# 2 一、测试环境准备
## 2.1 创建用户及资源组
```sql
CREATE RESOURCE GROUP IF NOT EXISTS rg_5000 RU_PER_SEC=5000;
CREATE RESOURCE GROUP IF NOT EXISTS rg_5000_high RU_PER_SEC=5000 PRIORITY = HIGH;
CREATE RESOURCE GROUP IF NOT EXISTS rg_3000 RU_PER_SEC = 3000;
CREATE RESOURCE GROUP IF NOT EXISTS rg_3000_burstable RU_PER_SEC = 3000 BURSTABLE;
CREATE RESOURCE GROUP IF NOT EXISTS rg_30000_high RU_PER_SEC=30000 PRIORITY = HIGH;
CREATE RESOURCE GROUP IF NOT EXISTS rg_30000_low RU_PER_SEC=30000 PRIORITY = LOW;
CREATE USER 'usr_rg_5000'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_5000;
GRANT ALL ON *.* TO 'usr_rg_5000'@'%';
CREATE USER 'usr_rg_5000_high'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_5000_high;
GRANT ALL ON *.* TO 'usr_rg_5000_high'@'%';
CREATE USER 'usr_rg_3000'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_3000;
GRANT ALL ON *.* TO 'usr_rg_3000'@'%';
CREATE USER 'usr_rg_3000_burstable'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_3000_burstable;
GRANT ALL ON *.* TO 'usr_rg_3000_burstable'@'%';
CREATE USER 'usr_rg_30k_high'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_30000_high;
GRANT ALL ON *.* TO 'usr_rg_30k_high'@'%';
CREATE USER 'usr_rg_30k_low'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_30000_low;
GRANT ALL ON *.* TO 'usr_rg_30k_low'@'%';
```
## 2.2 准备测试数据
```
tiup-bench tpcc prepare --warehouses 100 -D tpcc_test --dropdata -H 172.18.x.x -U usr_rg_3000 -p 123 -P 4000 -T 50
tiup-bench tpcc prepare --warehouses 100 -D tpcc_test2 --dropdata -H 172.18.x.x -U usr_rg_3000 -p 123 -P 4000 -T 50
```
# 3 二、测评方案
## 3.1 2.1 TiDB流控测评
**测试目标:**
- 不同资源组连到同一个TiDB上,测试不同资源组之间的隔离性
- 同一个用户连到不同TiDB上,测试同一用户的Quota是否共用
- 同一资源组不同用户,测试同一资源组的Quota是否共用
### 3.1.1 2.1.1 不同资源组的隔离性
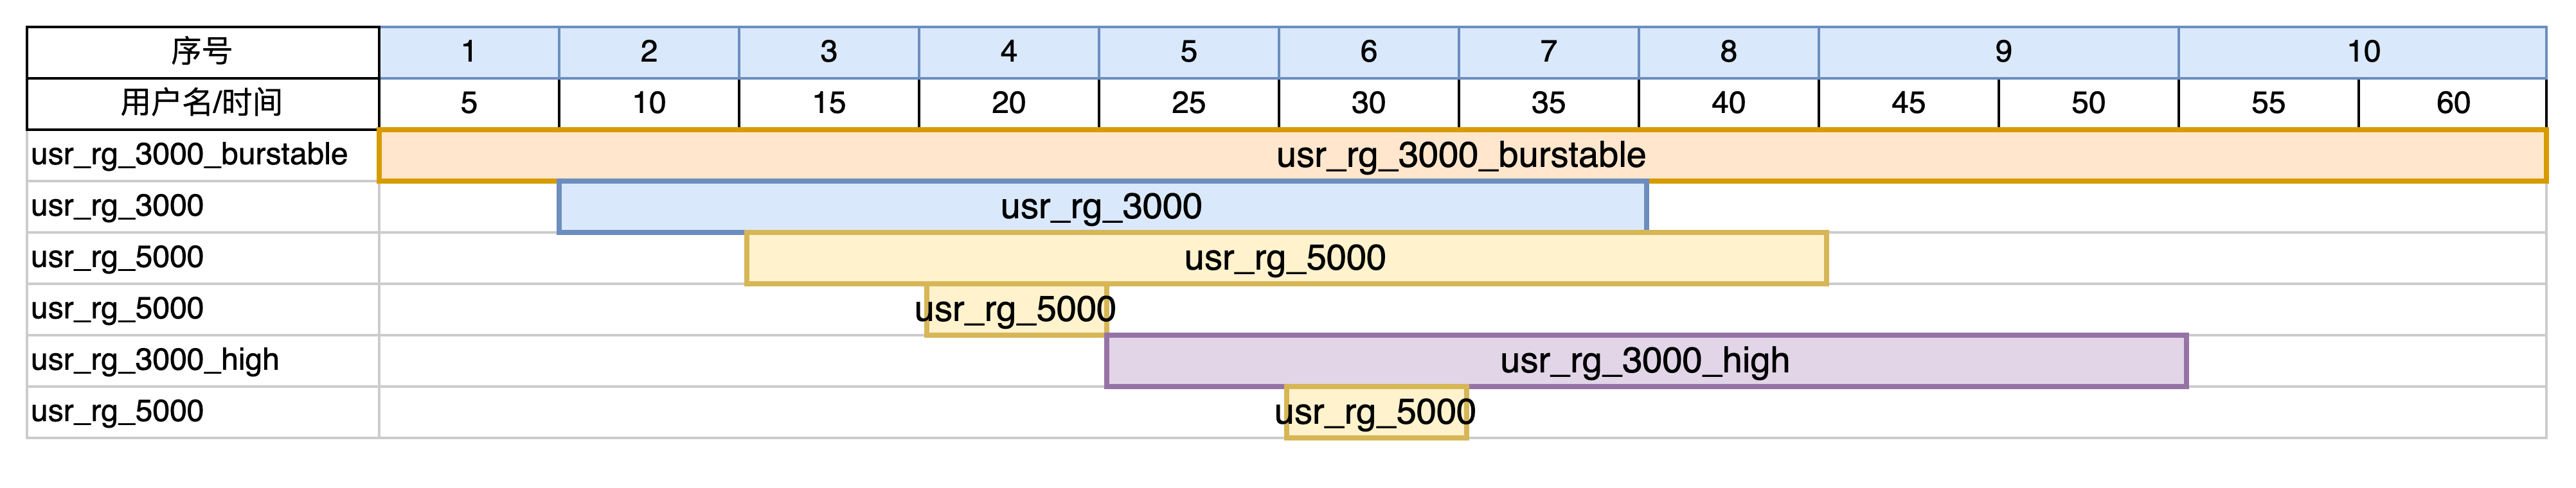
```bash
#! /bin/bash
# 1. 使用usr_rg_3000_burstable用户作为测试的背景噪音,令TiDB的CPU尽可能高
echo "$(date +"%F %T"): start bench use usr_rg_3000_burstable for 2h"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_3000_burstable -p 123 -P 4000 -T 50 --time 2h >usr_rg_3000_burstable.log &
# 2. 5-35min. 3000 for 30m (后续每隔5min启动一个测试用户进行压测)
sleep 300
echo "$(date +"%F %T"): start bench use usr_rg_3000 for 30m"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_3000 -p 123 -P 4000 -T 50 --time 30m >usr_rg_3000.log &
# 3. 10-45min. 5000 for 30m
sleep 300
echo "$(date +"%F %T"): start bench use usr_rg_5000 for 30m"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_5000 -p 123 -P 4000 -T 50 --time 30m >usr_rg_5000.log &
# 4. 15-20min. 5000 for 5m
sleep 300
echo "$(date +"%F %T"): start bench use usr_rg_5000 for 5m"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_5000 -p 123 -P 4000 -T 50 --time 5m >usr_rg_5000-2.log &
#5. 25-55min. 3000 high for 30m
sleep 300
echo "$(date +"%F %T"): start bench use usr_rg_3000_high for 30m"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_3000_high -p 123 -P 4000 -T 50 --time 30m >usr_rg_3000_high.log &
# 6. 30-35min. 5000 for 5m
sleep 300
echo "$(date +"%F %T"): start bench use usr_rg_5000 for 5m"
nohup tiup-bench tpcc run -D tpcc_test2 --host 172.18.x.x -U usr_rg_5000 -p 123 -P 4000 -T 50 --time 5m >usr_rg_5000-2.log &
```
**测试结果:**
**时序图**
**测试结果**
**结果解析**
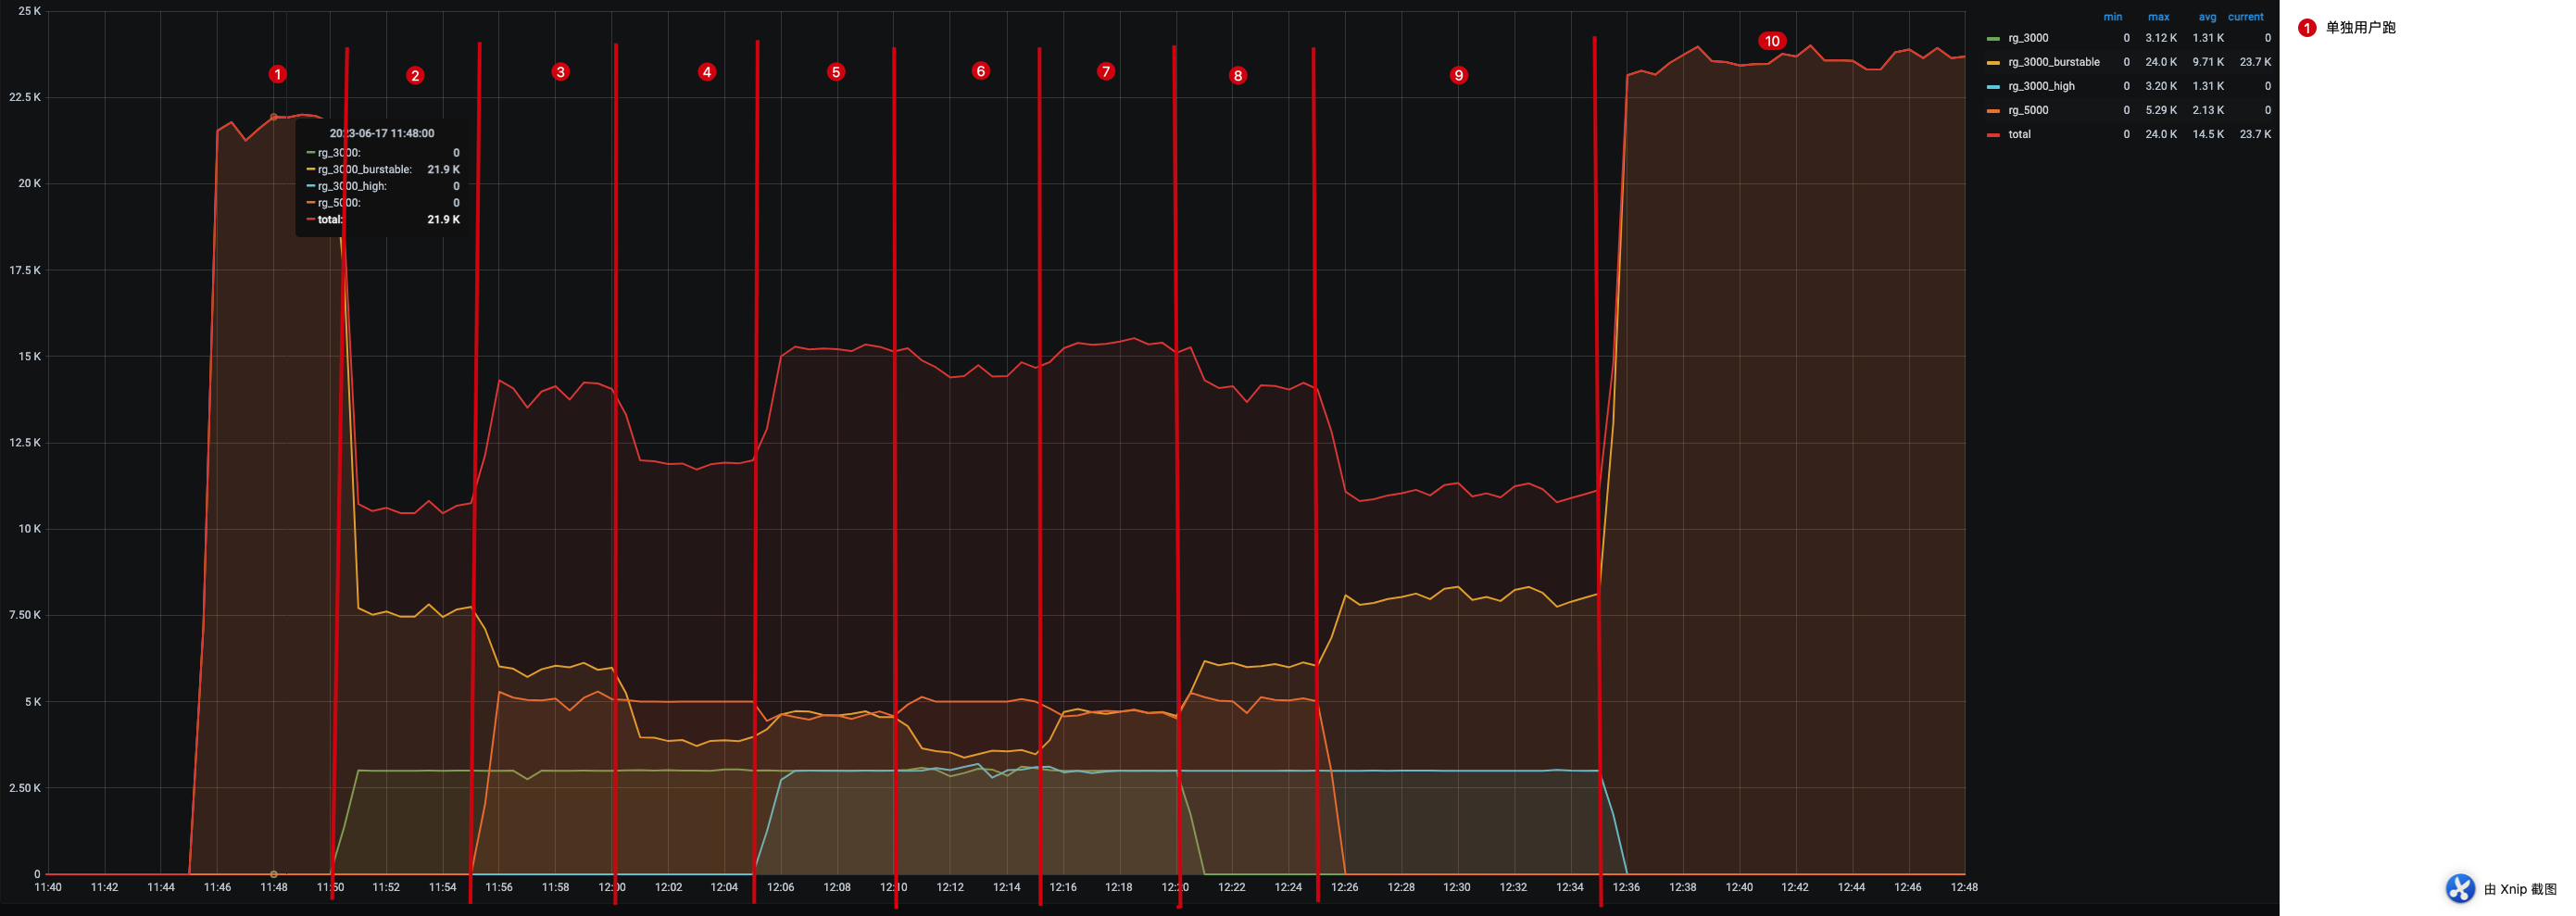
1. **阶段1:** 由于只有`usr_rg_3000_burstable`一个用户在使用集群,虽然Quota设置为3k,但因为设置了`BURSTABLE`可以跑到22k
2. **阶段2-4:** 并发一直在增大,TiDB的负载在逐渐增加,`usr_rg_3000_burstable`的流控曲线(黄色曲线)也越来越低,从22k、7.5k、6k逐步降低至4k
3. **阶段4:** 虽然使用`usr_rg_5000`用户新增了一个TPCC压测进程,但是总的资源消耗不变,还是5k。
4. **阶段5:** 随着`usr_rg_5000`一个压测进程结束,`usr_rg_3000_burstable`的资源从4k增加到5k(不过`usr_rg_5000`总的资源消耗略有下降,从5k下降至4.8k,可能是TiDB压力太大导致的)
5. **阶段6:** 继续使用 `usr_rg_5000` 用户新增了一个TPCC压测进程, 这一场景其实和阶段4比较类似,不过新增了`usr_rg_3000_high`资源组的压测进程,此时TiDB-Server的压力是最大的,几个资源组的曲线都略有波动,不过波动不大
6. **阶段7-10:** 随着其他资源组的压测进程逐渐结束,TiDB的负载在逐渐降低,`usr_rg_3000_burstable`的流控曲线(黄色曲线)也越来越高,逐步回升到24k。
由此来看,TiDB-Server层的流控还是比较符合预期的,当负载压力小的时候,允许部分用户超额使用资源,当负载压力大的时候,又能保证其他用户的Quota正常。
### 3.1.2 2.1.2 同一用户不同 tidb-server
**测试命令**
```bash
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_3000 -p 123 -P 4000 -T 50 --time 5m >usr_rg_3000.log.1 &
sleep 60;
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_3000 -p 123 -P 14000 -T 50 --time 5m >usr_rg_3000.log.2 &
```
**测试结果**
**结果解析**
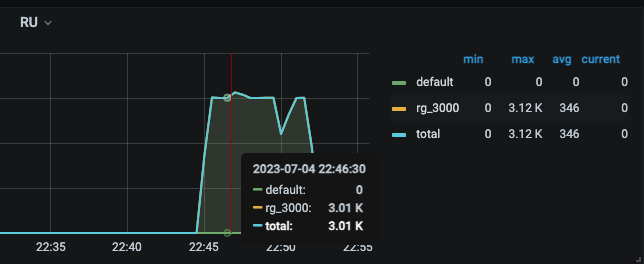
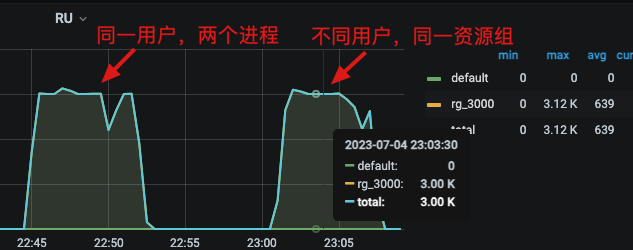
> - 观察RU使用曲线:在第二个压测进程启动后,资源使用会短时间高于Quota;当第一个压测进程结束后,资源使用会短时间低于Quota;不过很快就会回归正常Quota。
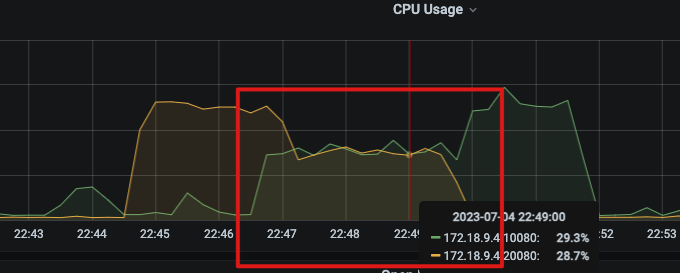
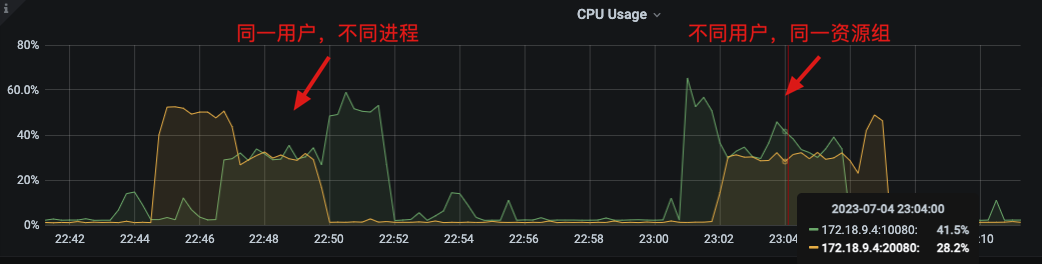
> - 观察tidb-sever的CPU曲线:当只有一个压测进程在跑时候,单个tidb-server的CPU是正常使用的,当两个压测进程共同跑时候,两个tidb-server会平均分配负载,达到负载均衡的状态,更合理使用资源。
### 3.1.3 2.1.3 不同用户同一资源组
**压测命令**
```sql
CREATE USER 'usr_rg_3000_2'@'%' IDENTIFIED BY '123' RESOURCE GROUP rg_3000;
grant all on *.* to 'usr_rg_3000_2'@'%';
```
```bash
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_3000 -p 123 -P 4000 -T 50 --time 5m >usr_rg_3000.log.1 &
sleep 60;
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_3000_2 -p 123 -P 14000 -T 50 --time 5m >usr_rg_3000.log.2 &
```
**压测结果**
**结果解析**
> 通过监控曲线,可以看到同一资源组的两个不同用户,和同一用户两个不同压测进程的曲线是基本一致的,说明同一资源组内的不同用户是共享Quota的。
### 3.1.4 2.1.4 总结
因为同一资源组内不同用户是共享Quota的,所以个人理解的TiDB的流控最佳实践为:
> - 对所有资源组都设置`BURSTABLE`属性,这样才能提高TiDB-Server的资源利用率。
> - 针对OLAP场景的用户,可以设置一个较小的Quota,当资源紧张时候,让它们尽可能小的占用资源,不影响OLTP的查询。
## 3.2 2.2 TiKV调度能力测试
> 由于2.1的测试案例,只有一个TiDB-Server实例,最终的TiKV压力并不大,看不出来TiKV层的优先级调度能力。使用`tiup cluster edit-config`将tikv-server配置修改为`resource_control.cpu_quota: 400%`,降低TiKV的CPU资源。
通过`instance.tidb_force_priority`来对特定TiDB-Server上的查询来设置优先级,测试一下通过TiDB-Server隔离,和通过资源组来设置的优先级有什么区别。
```sql
mysql> show config where name like '%tidb_force_priority%';
+------+------------------+------------------------------+---------------+
| Type | Instance | Name | Value |
+------+------------------+------------------------------+---------------+
| tidb | 172.18.9.4:4000 | instance.tidb_force_priority | HIGH_PRIORITY |
| tidb | 172.18.9.4:14000 | instance.tidb_force_priority | LOW_PRIORITY |
+------+------------------+------------------------------+---------------+
2 rows in set (0.01 sec)
```
测试案例包括:
- 资源组PRIORITY不同,TiDB的PRIORITY相同
- 资源组PRIORITY相同,TiDB的PRIORITY不同
- 高PRIORIT的资源组连接低PRIORITY的TiDB vs. 低PRIORIT的资源组连接高PRIORITY的TiDB
### 3.2.1 2.2.1 资源组PRIORITY不同,TiDB的PRIORITY相同
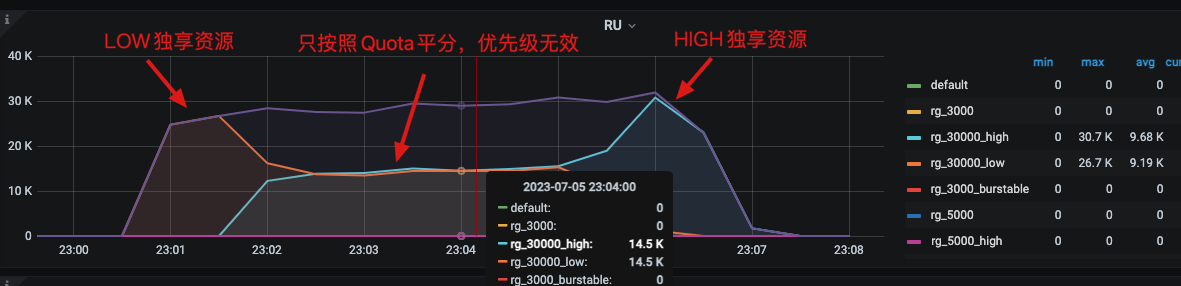
> 为使TiKV的CPU达到瓶颈,使用大Quota的资源组来进行测试
```bash
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_low -p 123 -P 4000 -T 100 --time 5m &
sleep 120;
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_high -p 123 -P 4000 -T 100 --time 5m &
```
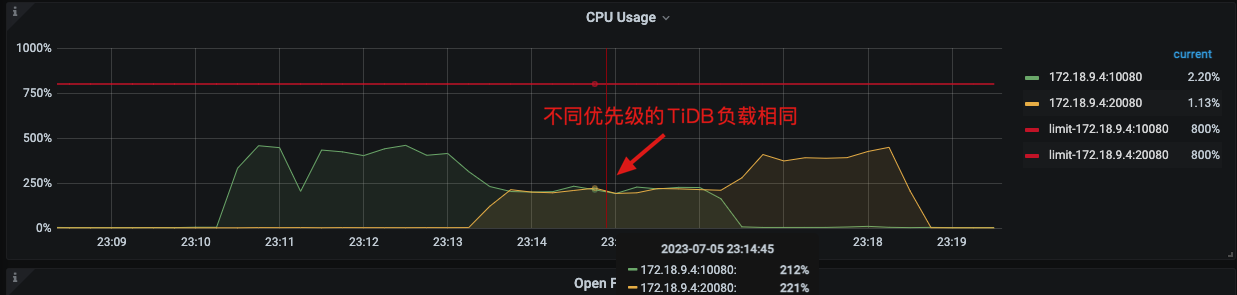
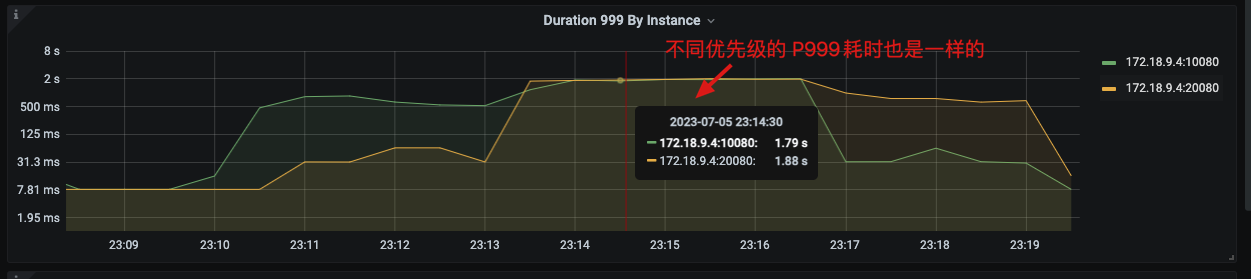
### 3.2.2 2.2.2 资源组PRIORITY相同,TiDB的PRIORITY不同
```bash
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_low -p 123 -P 4000 -T 100 --time 5m &
sleep 120;
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_low -p 123 -P 14000 -T 100 --time 5m &
```
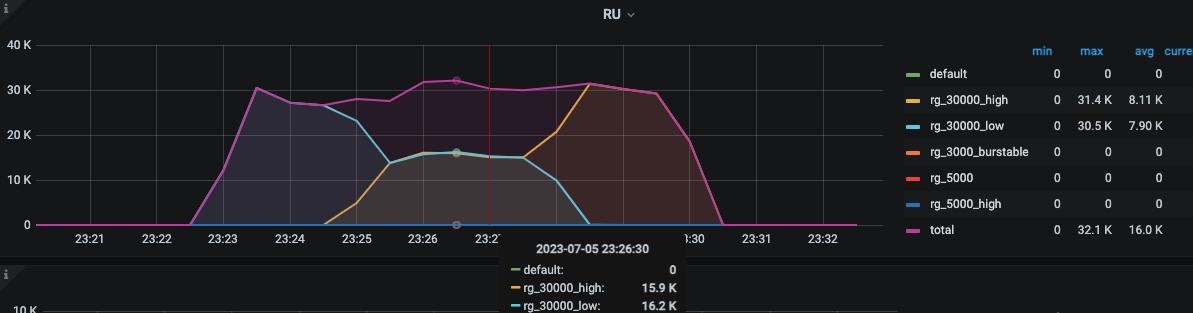
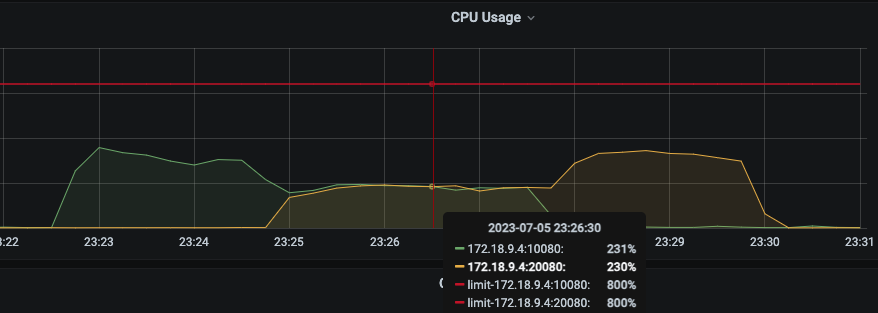
### 3.2.3 2.2.3 高PRIORIT的资源组连接低PRIORITY的TiDB vs. 低PRIORIT的资源组连接高PRIORITY的TiDB
```bash
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_low -p 123 -P 4000 -T 100 --time 5m &
sleep 120;
nohup tiup-bench tpcc run -D tpcc_test --host 172.18.9.4 -U usr_rg_30k_high -p 123 -P 14000 -T 100 --time 5m &
```
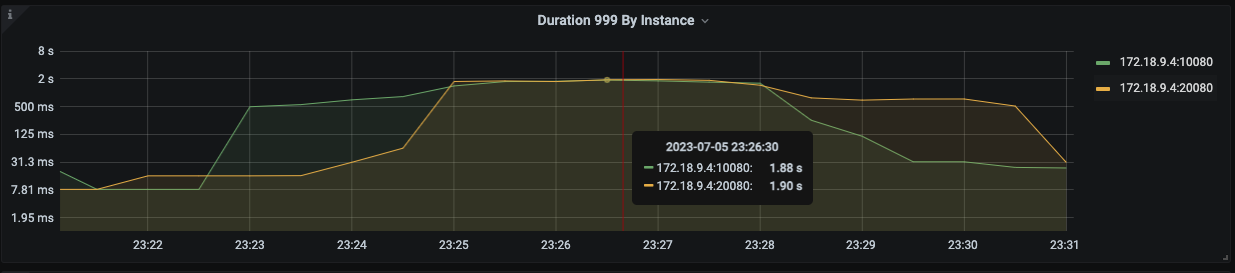
### 3.2.4 2.2.4 总结
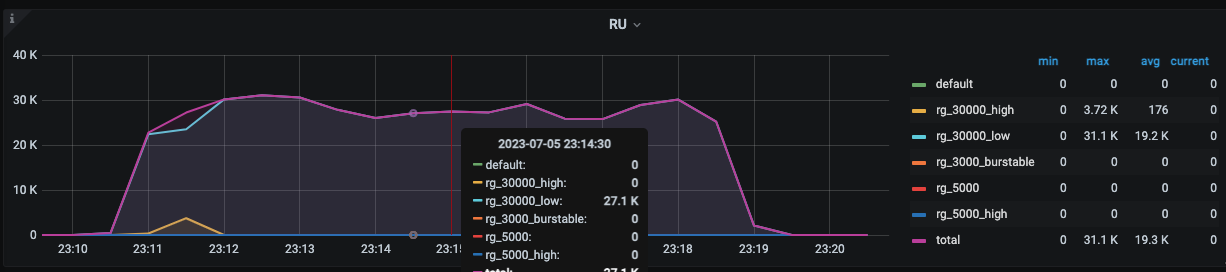
> 综合三次测试,可以发现不管是资源组优先级还是tidb-server的优先级,在TiKV层都是同样的处理,其调度能力并不能按照预期体现。