跳转到主要内容

1 - 2026-10-20-Tue

2026-10-20-Tue

🕐 创建时间:​2026-10-20 10:26 星期二

距离 ​2027-01-01​ 还剩 ​72 天,加油!

本周规划

  • **慢查询诊断**继续完善,要至少能对单个 SQL 做出比较准确的判断,能给出诊断案例,并给出下一步操作方案,并正确路由到后续跟进者

  • 智能诊断迁移 Agent 2.01 : 开始跟进,本周内完成迁移

  • Oncall 无人值守2:要总结最近一个月的 OnCall 数据,分析出来哪些可以完全靠 Agent 能解决,是否需要投入精力来搞。

  • 补齐 Q4 的 OKR:后 续要保证 OKR 的完成率 。

  • 诊断一下告警 ACK 率不满 100% 的原因:

    • 单库代理只读报错: ​5/6
    • RDS数据库主从同步异常( RDS database leader/follower synchronization exception): ​0/1
    • RDS database instance health status is abnormal:​0/1
  • 后续封禁结束,要重做 bits_ttp 的从库,修复数据不一致问题。


1 要做什么

  • OnCall 工单分析,首先要确认分析手段。

2 ✍ 做了什么

上午:

  • ‍

下午:

  • ‍

晚上:

  • ‍

3 ✍ 收获了什么

  • ‍


  1. 智能诊断迁移 Agent 2.0

    待迁移的项目

    标识/名称是否已经处理备注描述诊断模式诊断对象类型
    [analyze_ha_auto_switch_failed-test](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=analyze_ha_auto_switch_failed-test)
    不需要迁移判断 HA 决策树判断主库无法切换的原因——testAgent2.0alarm\_ha\_auto\_switch\_failed
    [diagnose_cpu_high](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=diagnose_cpu_high)
    **告警诊断在用,Z 项目专属,需要迁移到**诊断RDS CPU 高原因大模型rds\_cpu\_high
    [proxy_error_no_space_left](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=proxy_error_no_space_left)
    **告警诊断在用,这个经过治理后,很少出现了。**根据告警内容,诊断所属 DB 各节点的健康度是正常。大模型alarm\_no\_space\_left
    [check_cross_region_replication](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=check_cross_region_replication)
    **告警诊断在用**[单元化] 跨区域原生复制的备库指向的主库地址错误大模型alarm\_cross\_region\_replication\_master\_wrong
    [check_replication_status](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=check_replication_status)
    **告警诊断在用**检查复制状态失败的原因大模型alarm\_db\_replication\_status
    [check_ddl_ticket_status](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=check_ddl_ticket_status)

    这个应该是被 DBW 接管了,不再需要了。(奇怪,竟然还真的有调用,不过上面都是些诊断失败的案例_esc_newline_)

    分析用户 DDL 工单的当前状态,是否是因为配置了禁止rename时间窗口被阻塞大模型bpm\_user\_ticket
    [analyze_low_data_free](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=analyze_low_data_free)
    已经不再使用了,直接将路由改到 Agent 2.0 了诊断 DB 可用空间低的使用情况,并给出处理建议大模型alert\_disk\_space\_low
    [data_plane_slo_diagnose_fetch_relative_ticket](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=data_plane_slo_diagnose_fetch_relative_ticket)

    已经让 zhangdongdong.121 迁移到单独的 Agent 终端了。

    找到与SLO告警有关联的告警工单大模型slo\_diag\_context
    [rds_data_plane_slo_diagnose_summary](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=rds_data_plane_slo_diagnose_summary)对大模型的结果进行总结大模型slo\_diag\_context
    [rds_data_plane_slo_diagnose_beta](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=rds_data_plane_slo_diagnose_beta)RDS数据面SLO告警通用诊断场景大模型slo\_diag\_context
    [rds_conn_abnormal](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=rds_conn_abnormal)
    **在 RDS OnCall 机器人中有使用,只是简单迁移到 Agent 2.0,并没有真正实现这个接口**诊断 RDS 与连接相关的异常,注意本工具只会诊断当前数据库是否正常,不能协助对过去某个时间段的进行故障排查大模型region\_dbname
    [analyze_billed](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=analyze_billed)
    可以不迁移,文晖应该是临时创建的。分析一个RDS数据库的账单变化情况大模型-
    [query_metrics_by_bosun](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=query_metrics_by_bosun)
    应该也可以不迁移,应该没有被使用。通过 Bosun 语句来查询 Metrics 监控指标大模型rds\_dbname
    [rds_high_cpu_simple](https://rds.sre.bytedance.net/settings/data-ai-service/intelligent-diagnosis/scene-config?name=rds_high_cpu_simple)
    **在 RDS OnCall 机器人中有使用**诊断数据库库 CPU 利用率高的问题,注意这个工具只能诊断正在发生的 CPU 高故障场景,不能诊断历史某个时间段 CPU 高场景。大模型

    rds_region_dbname
    rds_region_dbname_role_host

    ‍  ↩︎
  2. Oncall 无人值守

    1. BKE 的无人值守包括什么内容?

    2. 无人值守的定义?

      1. 哪些工单可以被认为是无人值守?
      2. 自动化变更 + 智能检测 可以被认为是无人值守么?
      3. 巡检自愈 + 智能检测 可以被认为是无人值守么?
    3. 在 OnCall 方面的应用?权限问题?

      1. 问题排查类工作应该如何应用
      2. 主动回复
      3. 如果判断是否应该扩容?
      4. 自进化​ ==> ​辅助进化
    4. Agent Loop 建设

      1. ‍

    ‍

    参考资料:

    1. botmux 参考
    2. ‍
     ↩︎

2 - TiDB抖动排查路径

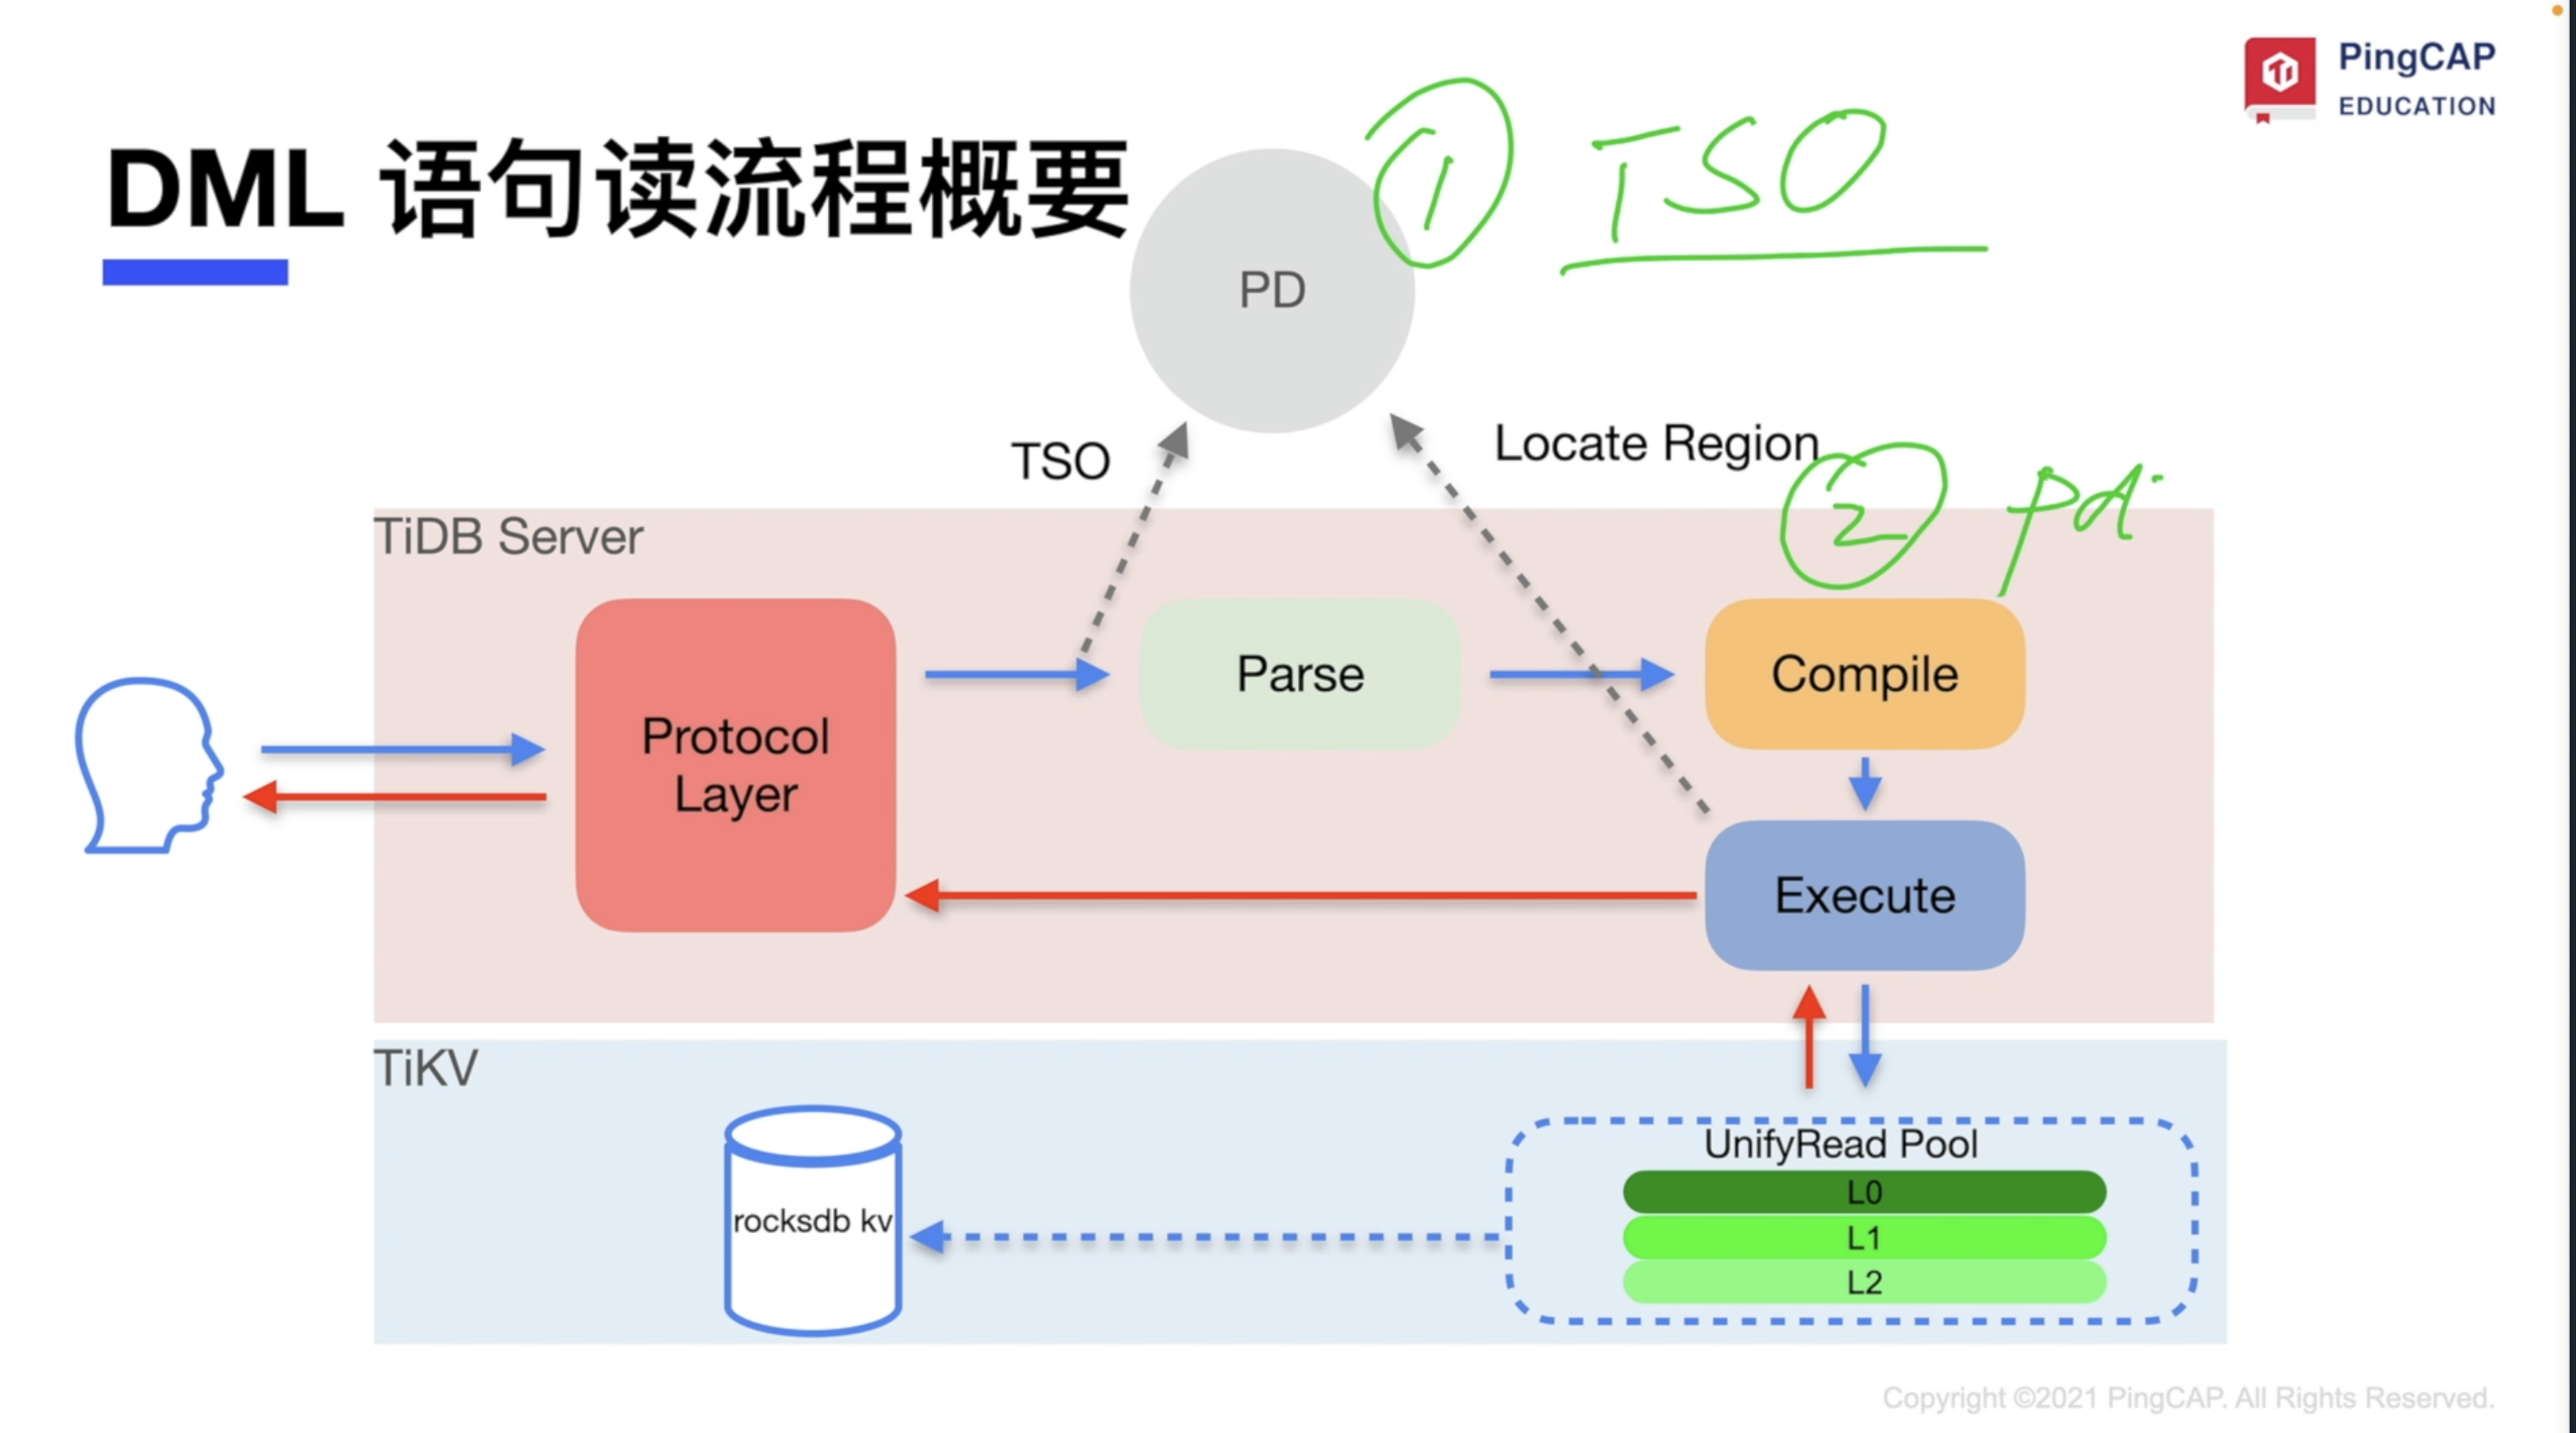
1 select执行流程

Pasted image 20220321114021

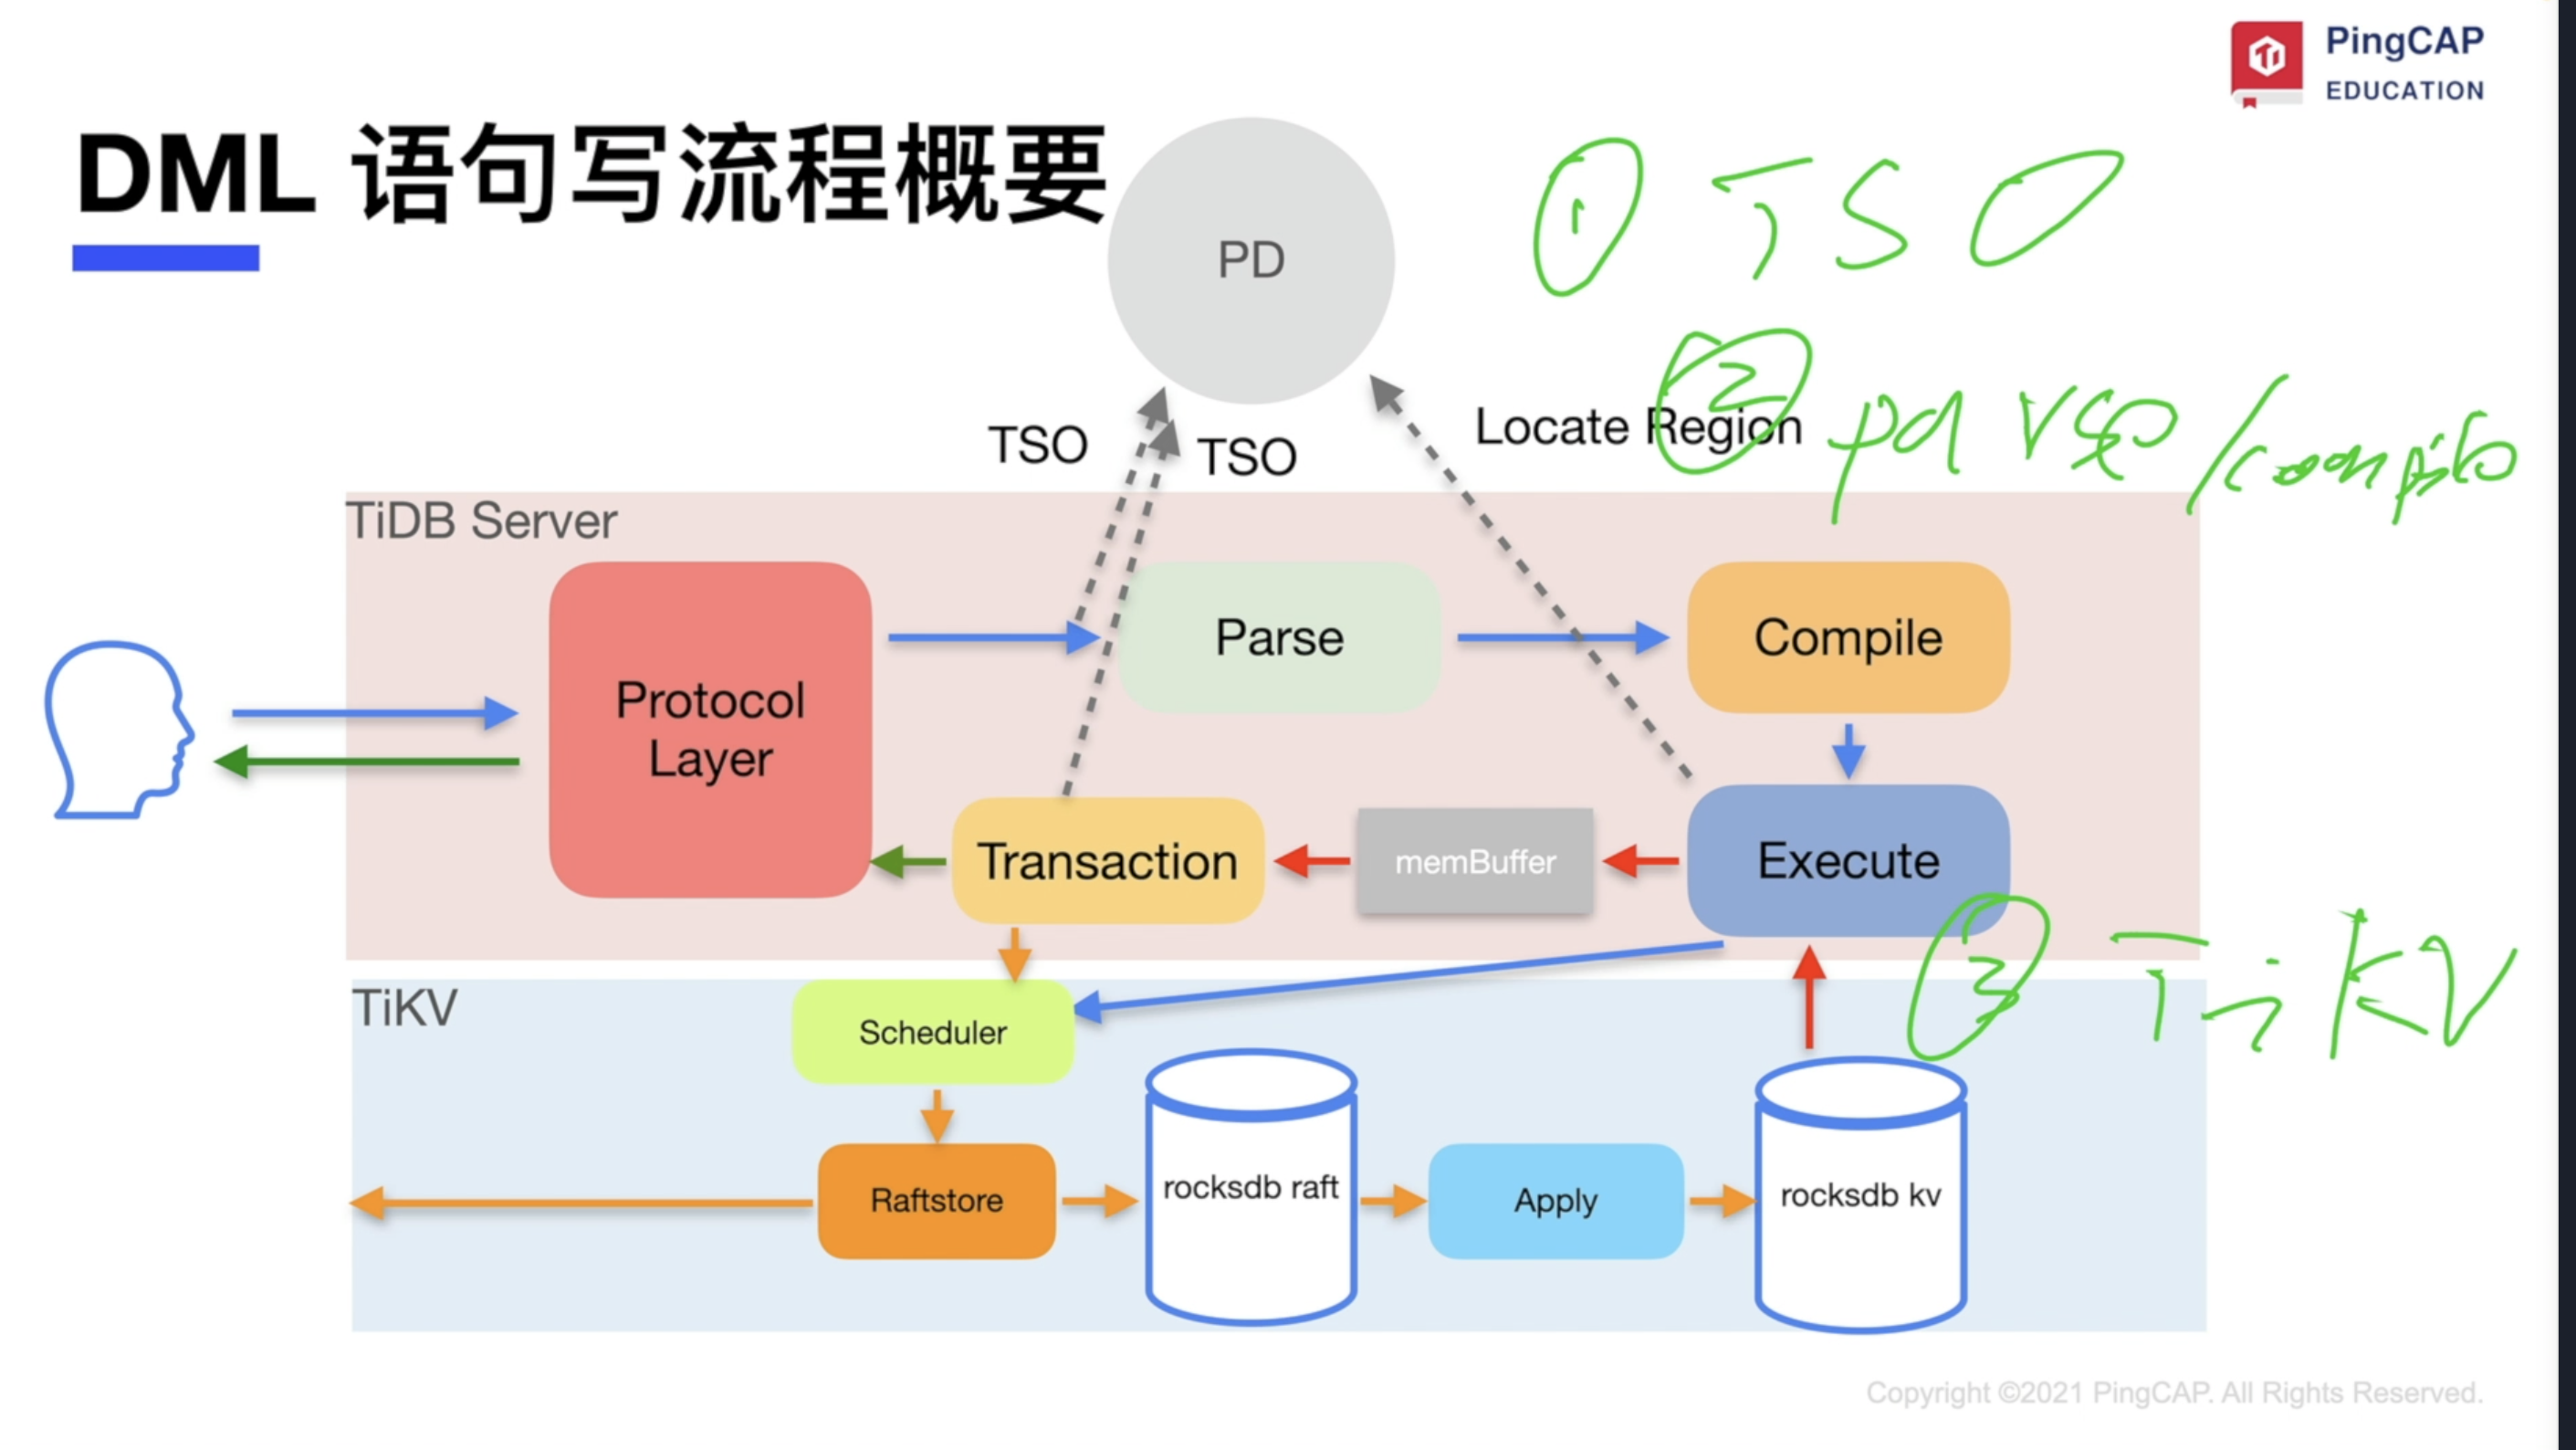
2 INSERT流程

Pasted image 20220321114035

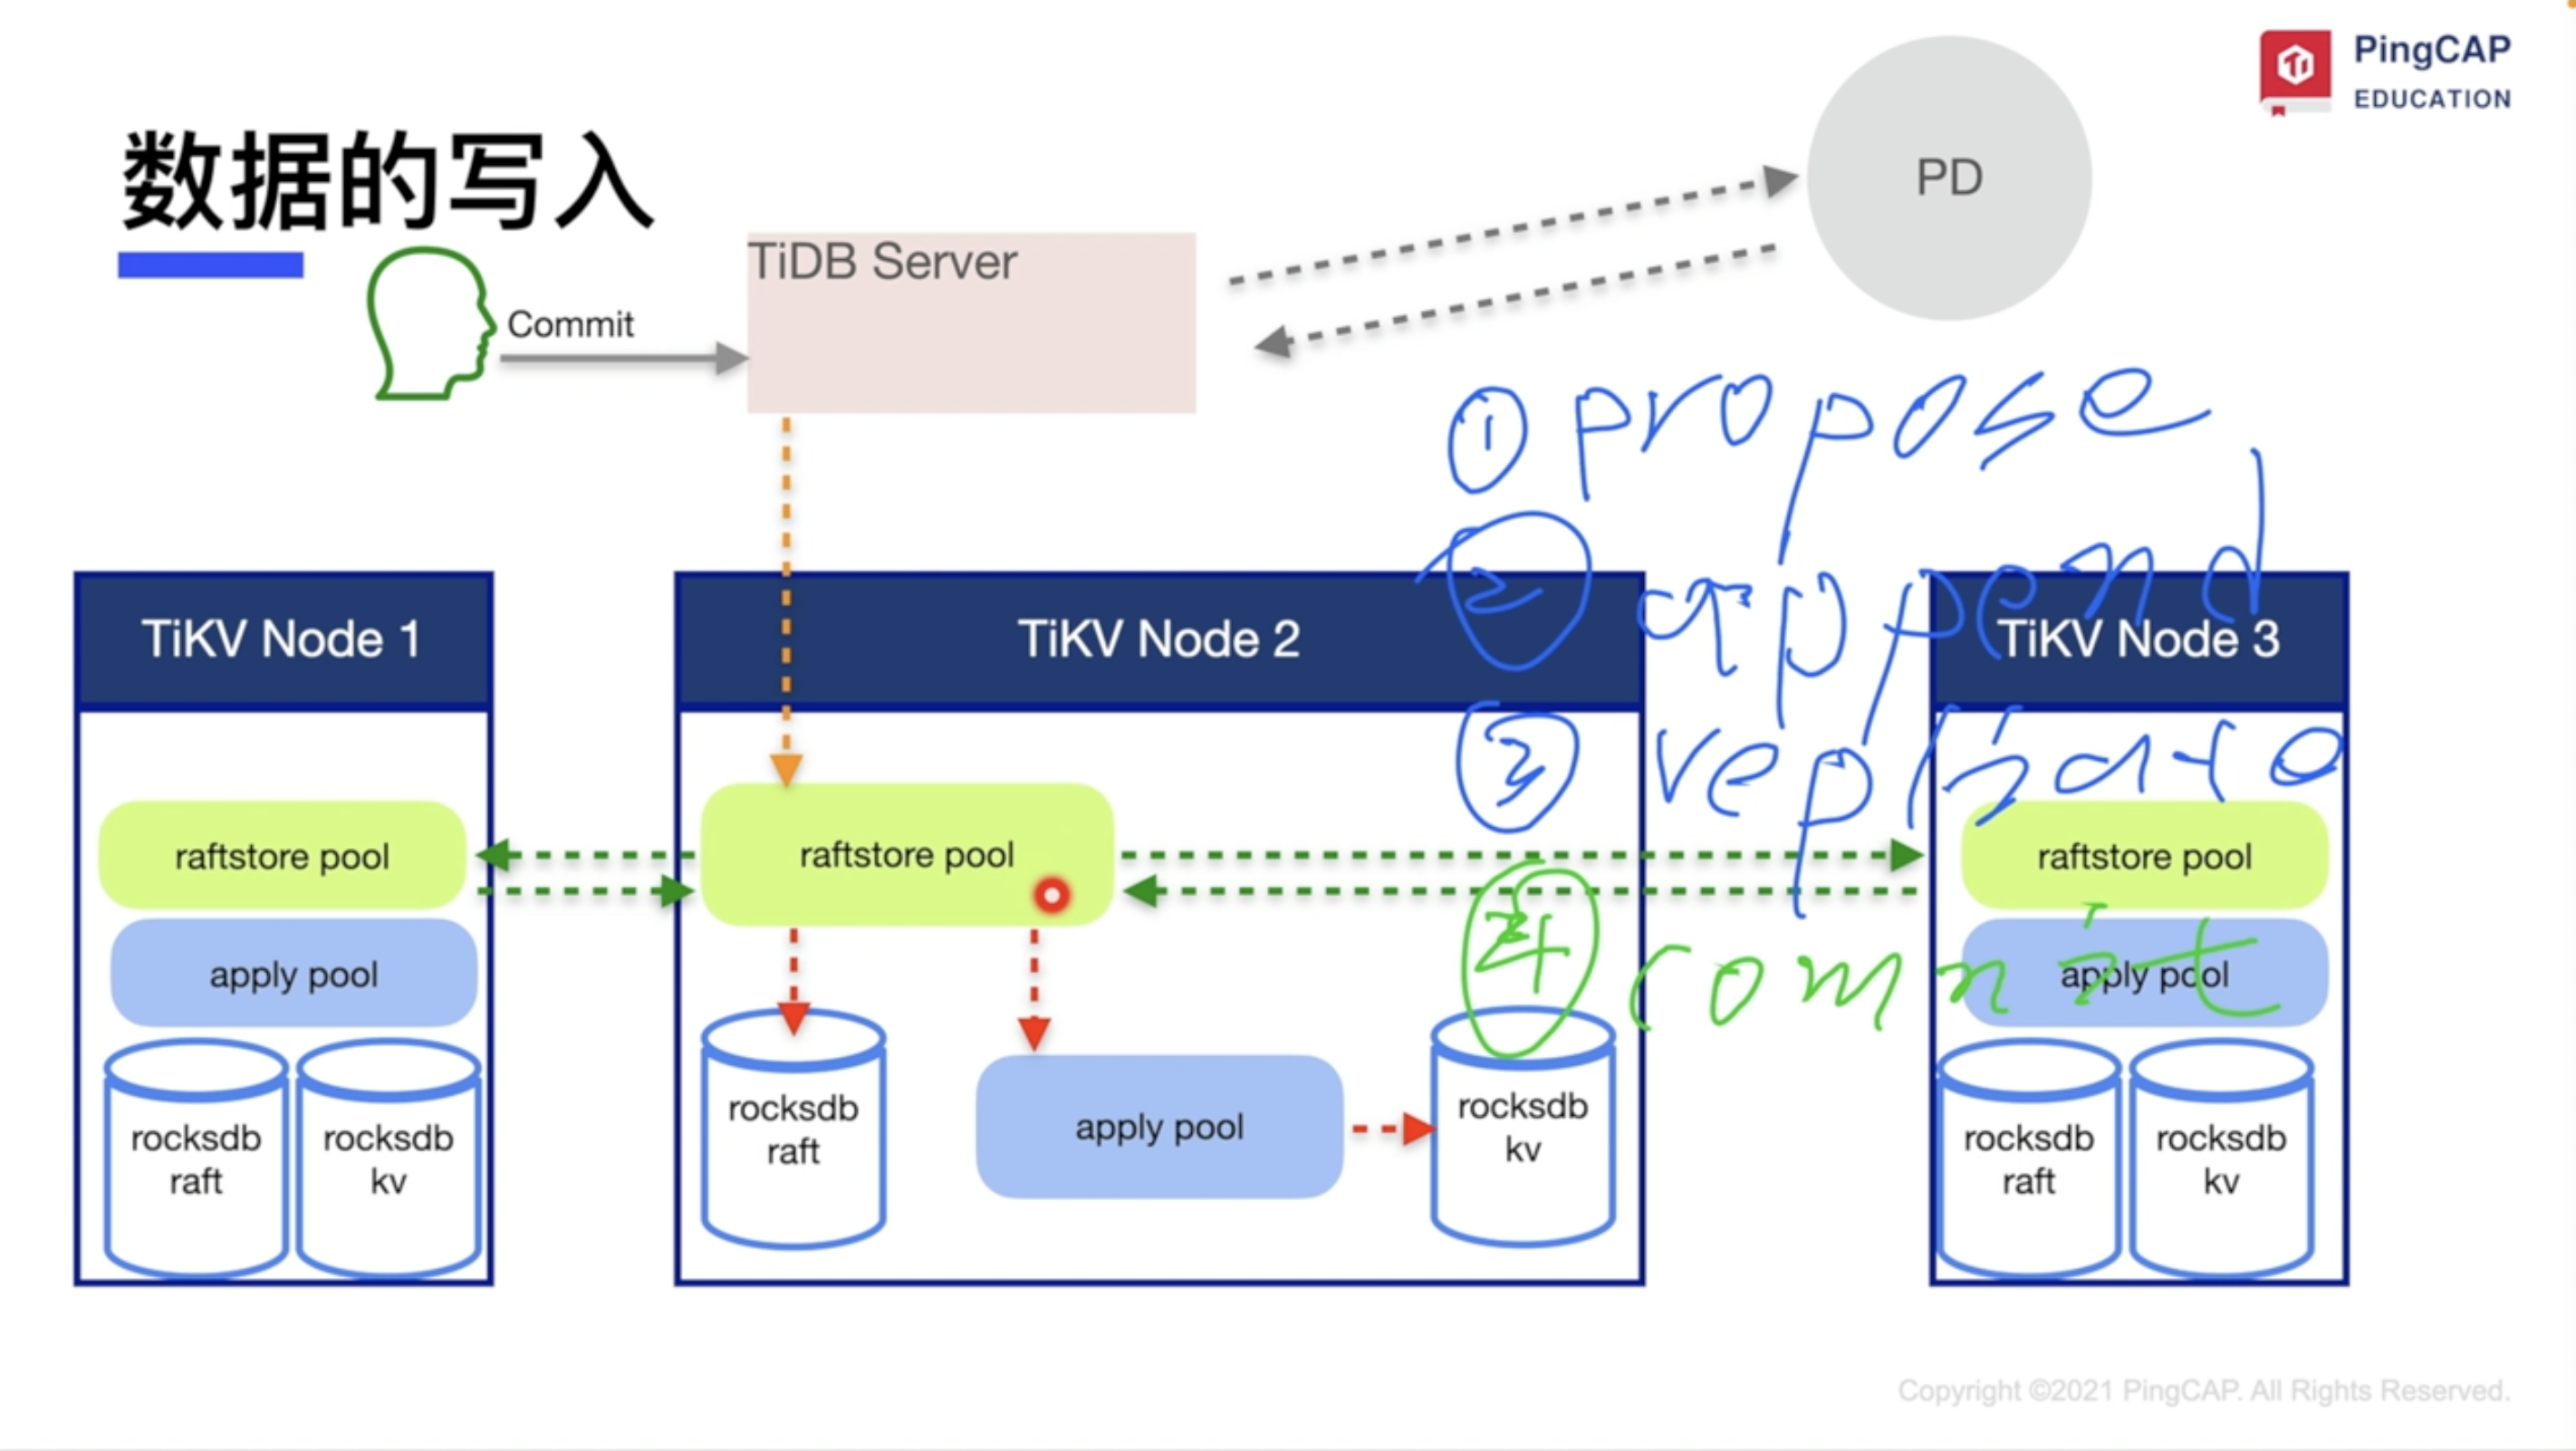
2.1 落盘步骤

Pasted image 20220321115327

‍

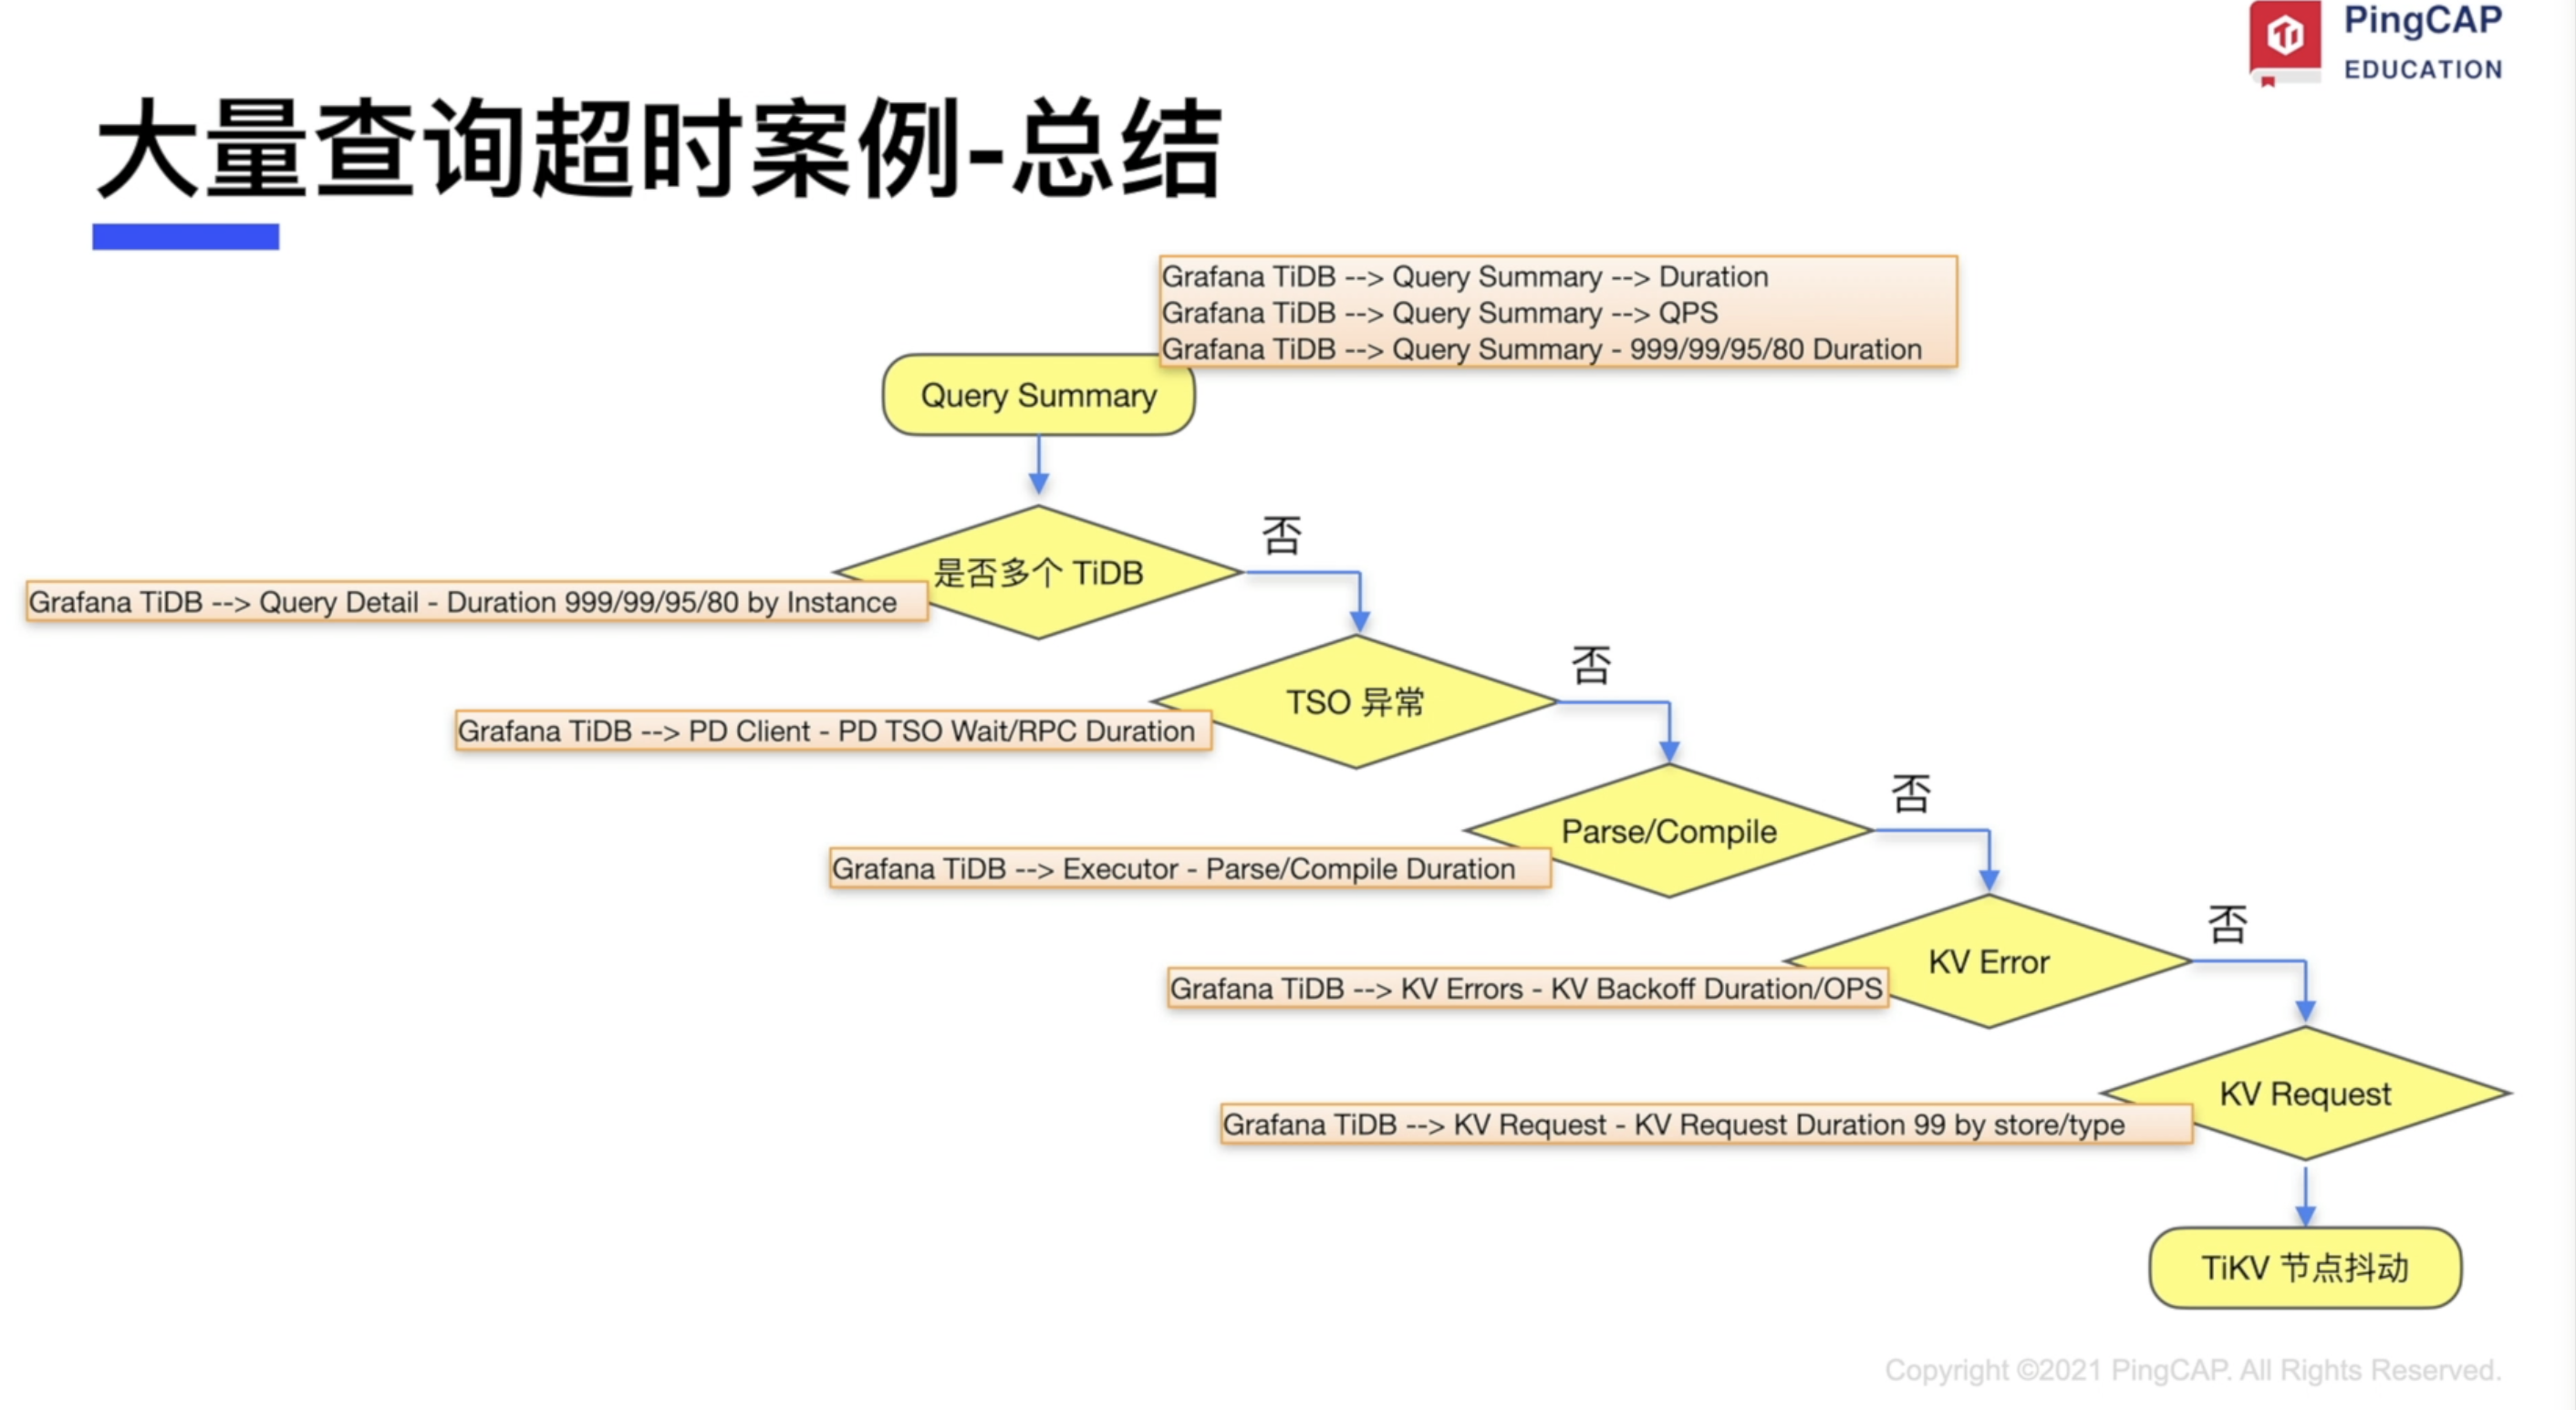
3 故障排查流程​​

Pasted image 20220321114826

‍

#TiDB#​ #故障排查#

‍

3 - 常用MySQL命令

  • 将某个字段/binary类型转换为utf8字符集的方法

    CONVERT(job_meta USING utf8) COLLATE utf8_unicode_ci
  • 统计BINLOG中EVENT分布

    # 按照时间段解析BINLOG
    mysqlbinlog -vv --start-datetime "2022-04-01 03:02:00" --stop-datetime "2022-04-01 03:08:00" mysql-bin.002572 >2572.txt
    
    # 将BINLOG过滤指定EVENT名到文件中
    cat 2572.txt | grep -E "^SET TIMESTAMP|### (INSERT|UPDATE|DELETE)" >table.txt
    # 查看单个事务的更改行数
    uniq -c table.txt
    # 统计某个时间段EVENT分布情况
    sort table.txt | uniq -c | sort -n -k1
  • 删除非系统库表

    select 
    	concat('drop database ',schema_name,';') 
    from information_schema.schemata 
    where 
        schema_name not in ('dba','mysql','performance_schema','sys','tmpdir','mysql','information_schema','binlog')
  • 查看索引是否被使用(需要到主从多台机器上都查一下)

    SELECT  
    	object_type,  object_schema,  object_name,  index_name,  count_star,  count_read,  COUNT_FETCH  
    FROM  PERFORMANCE_SCHEMA.table_io_waits_summary_by_index_usage 
    where 
    	object_schema='ying99_pomodel' and object_name='portfolio_composition';
  • 获取所有connection的某个 variables 状态

    select
        p.id, p.user, v.VARIABLE_NAME, v.VARIABLE_VALUE, p.time, p.command
    from
        information_schema.processlist p
        left join performance_schema.threads t on p.id = t.PROCESSLIST_ID
        left join  `performance_schema`.`variables_by_thread` v on t.thread_id = v.thread_id
    where
        v.VARIABLE_NAME like 'auto_increment_increment' and v.VARIABLE_VALUE = '1' ;
  • 跳过复制错误(GTID)

    SET GTID_NEXT = '127a3424-847c-11ea-90a6-00163e104a66:2743448';
    BEGIN; COMMIT;
    SET SESSION GTID_NEXT = 'AUTOMATIC';
    START SLAVE;
  • 统计单IP连接使用量

    select 
        User,substring_index(Host,':',1) as ip,count(1) as conn_num 
    from information_schema.processlist 
    group by ip having conn_num>=50 
    order by conn_num desc;
  • 统计大表

    select 
        table_schema,table_name, 
        (data_length + index_length) /(1024 * 1024 * 1024) as size_G 
    from information_schema.tables 
    order by size_G desc limit 30;
  • mydumper常用过滤库表

    /usr/local/bin/mydumper -h 10.242.149.120 -u zft_db_dump -p zft_db_dump -P 3306 --insert-ignore --load --lhost 127.0.0.1 --luser fmha_admin --lpassword ******* --lport 3306 -t 5 -v 1 --less-locking -c -o /data1/fmha_dump_data/2019053110073872 --enable-binlog --progressfile /data1/fmha_dump_data/2019053110073872/progress.log --logfile /data1/fmha_dump_data/2019053110073872/mydumper.log -x '^(?!(mysql.user$|mysql.db$|mysql.hosts$|mysql.tables_priv$|mysql.columns_priv$|mysql.procs_priv$|mysql.proxies_priv$|mysql.gtid_executed$|mysql.slave_master_info$|mysql.slave_relay_log_info$|mysql.slave_worker_info$|sys.*|information_schema.*|performance_schema.*))'
  • pt-online-schema-change工具常用参数

    pt-online-schema-change -h 127.0.0.1 -P 30002 -u ying99-testing -p ying99-testing --charset=utf8 --max-load="Threads_running:25" --critical-load="Threads_running:100" --progress="time,1" --nocheck-replication-filters --retries=10 --chunk-time=${CHUNKTIME} --chunk-size=${CHUNKSIZE} --chunk-size-limit=${CHUNKSIZELIMIT} --alter="${ALTERSQL}" D=${curr_alter_db},t=${curr_alter_table} --recursion-method=none --exec --print
  • 统计库表内存用量

    SELECT SUBSTRING_INDEX(event_name,'/',2) AS code_area, sys.format_bytes(SUM(current_alloc)) AS current_alloc FROM sys.x$memory_global_by_current_bytes GROUP BY SUBSTRING_INDEX(event_name,'/',2) ORDER BY SUM(current_alloc) DESC;
  • pt-kill

    pt-kill --match-user '^(?:eossvc-user)|(?:core-debezium-user)$' --victims all --interval 5 -v -u root --ask-pass -h 127.0.0.1 --print --kill
  • 找到MetaData LOCK

    SELECT
        locked_schema,
        locked_table,
        locked_type,
        waiting_processlist_id,
        waiting_age,
        waiting_query,
        waiting_state,
        blocking_processlist_id,
        blocking_age,
        substring_index(sql_text,"transaction_begin;" ,-1) AS blocking_query,
        sql_kill_blocking_connection
    FROM
        (
            SELECT
                b.OWNER_THREAD_ID AS granted_thread_id,
                a.OBJECT_SCHEMA AS locked_schema,
                a.OBJECT_NAME AS locked_table,
                "Metadata Lock" AS locked_type,
                c.PROCESSLIST_ID AS waiting_processlist_id,
                c.PROCESSLIST_TIME AS waiting_age,
                c.PROCESSLIST_INFO AS waiting_query,
                c.PROCESSLIST_STATE AS waiting_state,
                d.PROCESSLIST_ID AS blocking_processlist_id,
                d.PROCESSLIST_USER as blocking_processlist_user, 
                d.PROCESSLIST_TIME AS blocking_age,
                d.PROCESSLIST_INFO AS blocking_query,
                concat('KILL ', d.PROCESSLIST_ID) AS sql_kill_blocking_connection
            FROM
                performance_schema.metadata_locks a
            JOIN performance_schema.metadata_locks b ON a.OBJECT_SCHEMA = b.OBJECT_SCHEMA
            AND a.OBJECT_NAME = b.OBJECT_NAME
            AND a.lock_status = 'PENDING'
            AND b.lock_status = 'GRANTED'
            AND a.OWNER_THREAD_ID <> b.OWNER_THREAD_ID
            AND a.lock_type = 'EXCLUSIVE'
            JOIN performance_schema.threads c ON a.OWNER_THREAD_ID = c.THREAD_ID
            JOIN performance_schema.threads d ON b.OWNER_THREAD_ID = d.THREAD_ID
        ) t1,
        (
            SELECT
                thread_id,
                group_concat(   CASE WHEN EVENT_NAME = 'statement/sql/begin' THEN "transaction_begin" ELSE sql_text END ORDER BY event_id SEPARATOR ";" ) AS sql_text
            FROM
                performance_schema.events_statements_history
            GROUP BY thread_id
        ) t2
    WHERE
        t1.granted_thread_id = t2.thread_id \G
  • mysqldump 命令

    mysqldump --single-transaction --complete-insert --no-create-info --extended-insert=false -h 
  • 获取长时间没有释放的事务

    select 
        p.id, p.user, p.host, IF(p.DB IS NULL, '', p.DB) as db, timestampdiff(SECOND, t.trx_started, now()) as time
    from 
    	information_schema.PROCESSLIST p JOIN information_schema.INNODB_TRX t ON p.id = t.trx_mysql_thread_id
    where 
    	 t.trx_started<= date_sub(now(), interval 60 second);

‍

4 - MySQL slow_log日志采集方案

1 MySQL slow_log日志采集方案

1.1 背景

慢查询对线上的影响很大,而慢日志是发现慢查询SQL的最常用手段,所以对慢日志的收集和监控,是作为一个DBA的最常见需求。下面介绍一下常见的慢日志收集方案

1.2 方案一:将日志写入到表中,从表中定时获取慢查询

1.2.1 1. 开启方法

set global long_query_time=2;
set global slow_query_log=ON;
set global log_output='TABLE';

1.2.2 优点

  1. 查询灵活: 可以通过SQL来搜索满足条件的慢日志
  2. 采集方便:不需要额外组件支持,就可以远程查看慢日志

1.3 方案二:将日志输出到文件,使用filebeat来获取日志信息

1.3.1 1. 开启方法

set global long_query_time=2;
set global slow_query_log=ON;
set global log_output='FILE';
set global slow_query_log_file='slow_log.log';

1.3.2 2. 配套设施

如果使用Docker来运行MySQL和filebeat,需要在filebeat里挂载MySQL的日志目录,这个也比较坑。

1.3.2.1 2.1 日志采集

日志采集有多种组件,其中filebeat天然支持MySQL的慢日志,可以直接输出到ES中。

# vim /etc/filebeat/modules.d/mysql.yml
- module: mysql
  # Error logs
  error:
    enabled: true
    var.paths: ["/var/log/mysql/mysqld.log"]
    # Set custom paths for the log files. If left empty,
    # Filebeat will choose the paths depending on your OS.
    #var.paths:

  # Slow logs
  slowlog:
    enabled: true
    var.paths: ["/var/log/mysql/slow-log.log"]
    # Set custom paths for the log files. If left empty,
    # Filebeat will choose the paths depending on your OS.
    #var.paths:

1.3.2.2 2.2 日志滚动logratate

因为MySQL慢日志默认不会自己进行滚动,如果一直持续写入的话,单个日志文件会很大

/var/lib/mysql/localhost-slow.log {
    size 100M
    dateext
	dateformat -%Y%m%d_%s
    compress
    missingok
    rotate 10
    notifempty
    sharedscripts
    copytruncate
}

5 - Caddy泛域名配置 && hugo自动更新

背景

在腾讯云买了个轻量服务器,就想部署一些self-hosted服务,带来的一个后果就是要配多个域名,申请多套SSL证书。一开始还好,很快就能申请好,不过随着域名的增多,有时候新加域名得等一段时间才能申请成功。 好在caddy是支持泛域名证书(Wildcard certificates):

  1. 虽然caddy支持泛域名证书,但是得DNS服务商支持,默认情况下caddy并没有集成对应的插件,所以需要caddy下载页面,或者xcaddy来重新编译
  2. 很多域名其实只需要反向代理到内部端口,并不需要额外配置,配置其实都很类似。好在caddy提供snippet功能,可以很好做抽象
  3. 想达到博客自动更新的效果,还得使用webhook的插件
  4. 一时上头,买了3个域名,想多个域名都能访问,但是又不想重复配置

废话不多说,我来贴下我的Caddyfile吧

在这种配置下,以下几个域名都能正常工作:

  • waline.test.com, waline.test2.com
  • oss.test.com, oss.test2.com
  • blog.test.com, blog.test2.com

PS:当你往Github里Push时候,会自动触发webhook,自动更新博客
PPS:依赖插件有http.handlers.webhook, dns.providers.dnspod(此处和你使用哪个DNS服务商有关系)

{
	email "**********"
	log {
		output file /var/log/caddy.log
		level INFO
	}
}

(serve) {
	# proxy '$1.test.com' to port '$2'
	# just like: @blog host blog.test.com
	@{args.0} host {args.0}.{labels.1}.{labels.0}
	handle @{args.0} {
		encode gzip
		reverse_proxy localhost:{args.1}
	}
}

*.test.com, *.test2.com {
	tls {
		dns dnspod "{$DNSPOD_TOKEN}"
	}
	handle_errors {
		rewrite * /{http.error.status_code}.html
		file_server
	}
	import serve waline 	8360
	import serve oss 	    9000

	@blog host blog.{labels.1}.{labels.0}
	handle @blog {
        # 此处使用route,没有用handle。是因为handle在嵌套使用时候,最里层只能有一个handle       
		route /webhook {
			webhook {
				repo git@github.com:test/blog.git
				path /root/blog
				branch master
				key /root/.ssh/id_ed25519   # 此处没有用常见的id_rsa.pub,是因为webhook时候Github觉得密钥太弱,不允许使用
				secret Pa88w0rd
				command hugo --destination /var/www/blog --cleanDestinationDir
				submodule
			}
		}

		route {
			encode gzip
			root * /var/www/blog
			file_server
		}
	}

	handle {
		abort
	}
}

6 - 待填的坑

最近刚开始写blog,需要抽时间将之前的知识梳理一下,包括不限于:

  • MySQL
  • TiDB
  • Linux相关:ZFS, Openwrt等
  • 编程语言:SHELL, Python, Golang等
  • 工具类:Shadowsocks, Minio, NextCloud
  • Mac: MarkText
  • 博客: Caddy, Hugo, Picgo

PS: 不一定能写完,看情况吧🙈

7 - 一次TiDB负载搞排查

背景

  • TiDB Server两个节点CPU使用率都比较高 TiDB Server 两个节点 CPU 使用率
  • 查看QPS指标,可以看到14点到19点之间是基本没有流量的 QPS 指标,14 点到 19 点基本无流量
  • 登陆机器可以发现,有很多连接其实已经失效,但是还残留服务器上: 服务器上残留的失效连接
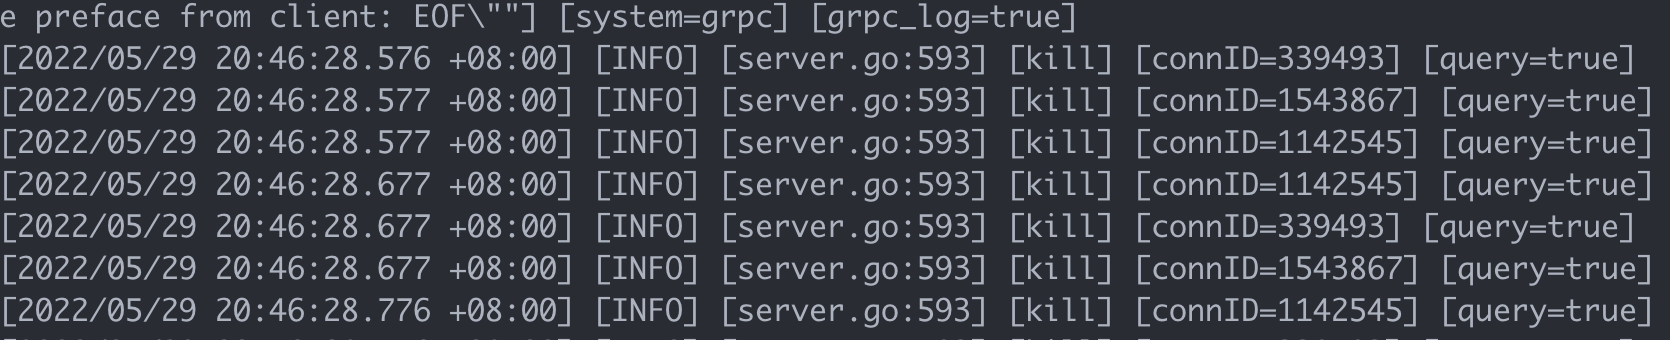
  • 怀疑Server负载高和这些诡异的SQL有关系,即便没有释放,也没办法KILL,但是还是占用了一个核的CPU 20220529204849
解决方案

  1. 将流量转移到其他机器,可选途径有:

    • 将机器从负载均衡上剔除,让新建连接不使用这台机器
    • 旧连接处理,有多种方案

8 - HUGO主题相关内容

安装主题

安装主题可以通过两种途径:

  1. 直接下载主题的ZIP文件,将文件解压到theme目录下。
  2. 通过git submodel方式,将主题作为git子模块来管理。

建议通过git submodel方式来管理,这样后续主题有更新,直接通过git submodel来更新即可。

修改主题

如果希望对主题默认的风格进行微调。不管是通过哪种方式安装的主题,切记:
别直接修改主题的文件!
别直接修改主题的文件!
别直接修改主题的文件!

可以通过两种方式进行修改:

  1. 好的主题会提供很多参数可以调整风格和内容,在config.toml|yaml文件里添加对应参数即可
  2. 如果是希望调整的地方,主题没有提供参数可修改,确实需要修改html文件。可以在项目根目录创建layouts目录,HUGO会项目的layouts里文件来覆盖主题对应的文件。这种后续主题升级后,可以直接升级,而不用担心自己做的修改被覆盖。

切换主题

如果没有修改主题,则直接修改config.toml文件的theme配置即可,HUGO就会自动切换主题。 但是往往我们会对主题做一些微调,这样的话,config.toml/layouts目录下就会有主题对应的配置/文件,如果想切换的话,因为每个主题的规划不同,新旧主题的配置/文件往往不能复用,每次切换都得调整。

我目前也没有找到很好的方法,来方便的切换两个主题,如果有方案的,希望评论里告诉我一下。


以下是遇到过的问题,先占坑,可能会鸽。。。

POST模板

图标

通过自动生成图标的网址,可以自动生成合适尺寸的图标。 博客根目录下创建static,将下载后的压缩包解压到这里即可

时区问题

评论

目录结构

部署

更新

9 - MySQL在线更改Binlog目录

线上使用共享表空间,因共享表空间没办法释放,导致磁盘可用空间太小,所以新找几台机器,重新导出导入,将业务迁移到新机器上。
因需要从备机导数据,需要保留binlog个数不固定,为避免导数机器被binlog撑满,将其他磁盘的目录挂载到binlog目录。

背景

线上使用共享表空间,因共享表空间没办法释放,导致磁盘可用空间太小,所以新找几台机器,重新导出导入,将业务迁移到新机器上。
因需要从备机导数据,需要保留binlog个数不固定,为避免导数机器被binlog撑满,将其他磁盘的目录挂载到binlog目录。

原理

  1. 将binlog目录挂载到其他分区

  2. 重新生成binlog/relay log日志,使其在新目录生成

    注1:因为操作会进行reset master操作,所以不适用下游有空库或者其他拉取binlog的服务(如DM、Debezium等)
    注2:如果可以接受停机的话,直接挂载目录,将Binlog文件复制到新目录更简单,对下游也没有影响

操作

  1. 将备机写入暂停,记录操作前GTID/slave信息

    # 1. 停止复制线程,将备机数据固定
    stop slave;  
    
    # 2. 记录当前GTID/Binlog/Slave信息
    show master status\G 
    show slave status\G 
  2. 在另一分区创建新目录,并将新目录挂载到旧binlog目录

    mkdir ${new_binlog_dir}
    chown mysql:mysql ${new_binlog_dir}
    mount --bind ${new_binlog_dir} ${old_binlog_dir}
  3. 重置binlog和relay log,使其在新目录重新生成

    # 1. 清空master信息(会同时清空GTID/binlog),重新生成binlog文件
    reset master;
    
    # 2. 清空slave信息,重新生成relay log文件
    reset slave;
  4. 恢复复制关系,下面两种方式都可以恢复

    # 1. 手动设置第一步保存的GTID信息,使用auto prosition自动找点
    set global gtid_purged='{old_gtid}';
    change master to master_auto_position=1;
    start slave;
    
    # 2. 根据第一步保存的binlog位置,手动设置binlog位置
    change master to master_log_file='{old_file}', master_log_pos={old_pos}, master_auto_position=0;
    start slave;

10 - MySQL搭建Group Replicatiion

1. 安装MySQ(>=5.7.19)

具体安装方法,请百度或Google

2. GR准备工作

1. 更改配置文件

loose-为配置前缀,后边才是变量名。 正常情况下配置文件里参数是必须可用的,也就是必须先安装插件,后改配置文件,否则MySQL启动时会报错。加loose-前缀后,如果参数不存在,会先忽略报错,待插件安装后,会自动将对应参数设置为配置文件的值。

# group replication
binlog_checksum=NONE
transaction_write_set_extraction = XXHASH64
loose-group_replication_group_name = 'a0151174-f716-428f-a654-dd5dd4915b31'   #必须为uuid格式
loose-group_replication_start_on_boot = off
loose-group_replication_local_address = '10.52.29.7:33061' #内部端口(和MySQL对外端口不能一样)
loose-group_replication_group_seeds ='10.52.29.7:33061,10.164.158.39:33061,100.87.68.39:33061'
loose-group_replication_ip_whitelist='10.52.29.7,10.164.158.39,100.87.68.39'
loose-group_replication_bootstrap_group = off

## 多主模式
loose-group_replication_single_primary_mode=false
loose-group_replication_enforce_update_everywhere_checks=true

## 单主模式
loose-group_replication_single_primary_mode=true
loose-group_replication_enforce_update_everywhere_checks=false

2.搭建复制关系

  1. 修改hostname

    GR会使用hostname做master_host,所以必须:

    • 修改本机/etc/hostname,并配置全局/etc/hosts文件
    • 使用hostname命令修改内存中hostname
    • 修改后需重启MySQL(使MySQL加载更新后的hostname值,在MySQL内部hostname是只读变量)
  2. 创建复制用户

    注意:MGR通过GTID确认数据一致性,所以需要保证接入实例GTID一致,因此创建复制用户时需要设置set sql_log_bin=off

    set session sql_log_bin=off;
    grant select,replication client,replication slave on *.* to 'repl_user'@'host ip' identified by 'repl_passwd';
    set session sql_log_bin=on;
  3. 搭建复制关系

    change master to master_user='repl_user',master_password='repl_passwd' for channel 'group_replication_recovery';

    3. 启动MGR

  4. 安装插件

    install PLUGIN group_replication SONAME 'group_replication.so';
  5. 首个节点启动group replication

    SET GLOBAL group_replication_bootstrap_group=ON;
    START GROUP_REPLICATION;
    SET GLOBAL group_replication_bootstrap_group=OFF;
  6. 其他节点启动

    START GROUP_REPLICATION;

核查集群状态

select * from mysql.slave_master_info\G
select * from performance_schema.replication_group_members;

注意事项

  • 安装时常见错误
    • group_replication_group_name不是uuid格式
    • 未设置group_replication_ip_whitelist,节点不能互通
    • 未设置系统hostname,节点无法从集群搭建复制关系
    • chanel_name名字不是group_replication_recovery
    • 未设置sql_log_bin=off导致各节点gtid不一致
    • 未开启performance_schema,导致集群状态没办法查看

11 - Linux端口转发方式

ssh端口转发模式

这种方式,有以下特点:

  1. 可以在本地执行,也可以在服务器执行,部署方案灵活;
  2. 通信会经过ssh加密,安全性好;
  3. 同样是因为经过ssh加密,所以性能比较低
ssh -L ${local_port}:${server_ip}:${server_port} -fN root@${proxy_ip}

xinetd 端口转发

  1. 没有加密,性能高;
  2. 在应用层转发,不需要root权限
  • 安装xinetd:yum install -y xinetd

  • 增加service配置:

    [root@1111 /etc/xinetd.d]# cat proxy-mysql
    service proxy-mysql
    {
       disable = no
       type = UNLISTED
       socket_type = stream
       protocol = tcp
       wait = no
       redirect = ${server_ip} ${server_port}
       bind = 0.0.0.0
       port = 3306
       user = nobody
    }
  • 启动转发:xinetd -f /etc/xinetd.d/proxy-mysql

Iptables方式

  1. 在内核层来进行转发,性能高;
  2. 需要root权限。
iptables -P FORWARD ACCEPT
iptables -t nat -A PREROUTING -p tcp -m tcp --dport ${local_port} -j DNAT --to-destination ${server_ip}:${server_port}
iptables -t nat -A POSTROUTING -p tcp -m tcp --dst ${server_ip} --dport ${server_port} -j MASQUERADE